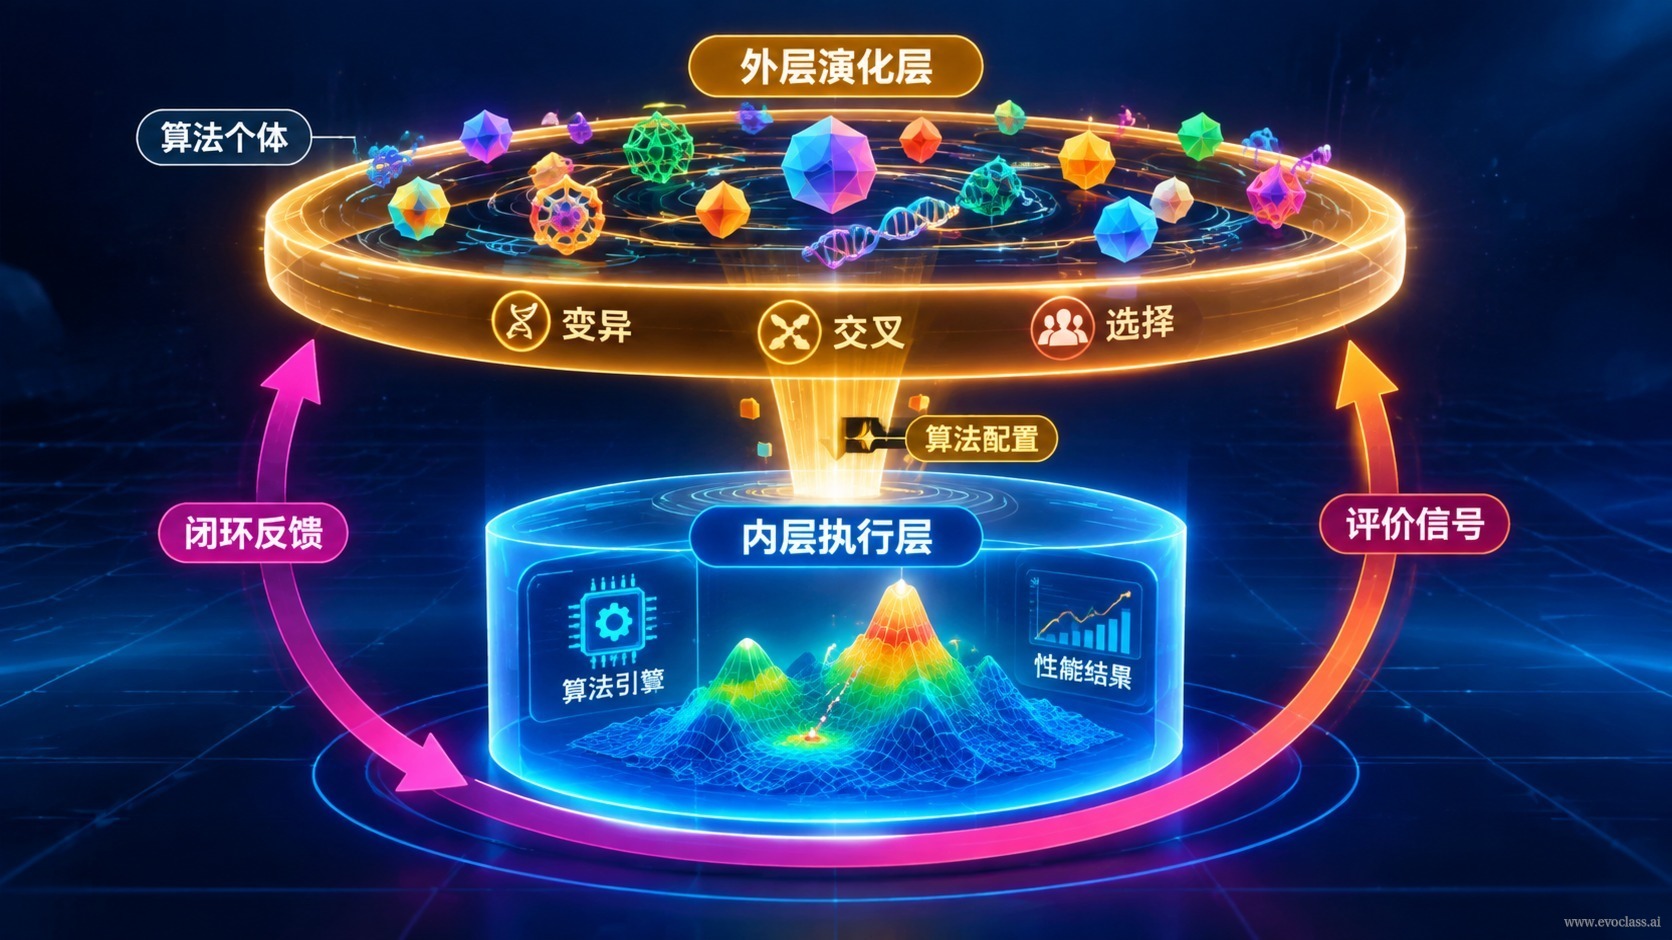
经典的优化流程把注意力全部放在解空间:固定一组差分进化(DE)配置——变异策略、交叉率 CR、缩放因子 F、种群规模 NP——然后反复迭代去逼近问题的最优解。但有一个问题始终悬而未决:这套配置本身是谁选的?MetaDE 的回答是把“产生候选方案的方法”也当作被演化的对象:外层再套一层演化算法,专门搜索更好的算法配置,于是形成“用演化算法改进演化算法”的双层优化闭环。
内层与外层:职责如何切分
- 内层:拿到一组具体的 DE 配置,在真实任务上跑一次完整求解,产生候选解,并返回一个可比较的性能评价。
- 外层:把 DE 的配置、超参数或策略组合编码为个体,以任务性能作为适应度,用演化算法(选择、重组、变异)更新下一代配置。
目标转移:从“找解”到“找会找解的方法”
MetaDE 改变的并不是优化器的实现,而是优化的目标层级。传统 DE 的产出是一个解向量;MetaDE 的产出是一套能在这类任务上稳定产出更好解的算法配置。也就是说,搜索的对象从“答案”上升为“生产答案的机器”。这使得一次外层搜索的成果可以迁移到同一族的其他实例上复用。
反馈闭环与工程前提
整个系统靠一条闭环串起来:外层下发配置 → 内层执行求解 → 性能回传 → 外层据此更新下一代配置。需要注意的是,外层的一个个体要获得适应度,就必须付出一次(往往是多次并行)完整内层运行的代价,因此 评估成本管理 与 并行调度 是系统设计的核心。正是 GPU 能够把大量内层任务同时跑起来,才让这种“评估昂贵”的元优化在工程上变得可行。
一句话抓住本质
内层负责“算出什么”,外层负责“怎么算才更好”。两层共享同一个适应度信号——任务性能,这也正是它们能形成闭环的原因。
MetaDE 双层优化架构
该架构图分为内外两层:外层把差分进化的变异策略、交叉率、缩放因子与种群规模编码为个体并用演化算法更新,内层用这组配置在真实任务上完整求解,再把任务性能回传为外层适应度,形成评估昂贵的优化闭环。
MetaDE 双层优化架构
该架构图分为内外两层:外层把差分进化的变异策略、交叉率、缩放因子与种群规模编码为个体并用演化算法更新,内层用这组配置在真实任务上完整求解,再把任务性能回传为外层适应度,形成评估昂贵的优化闭环。