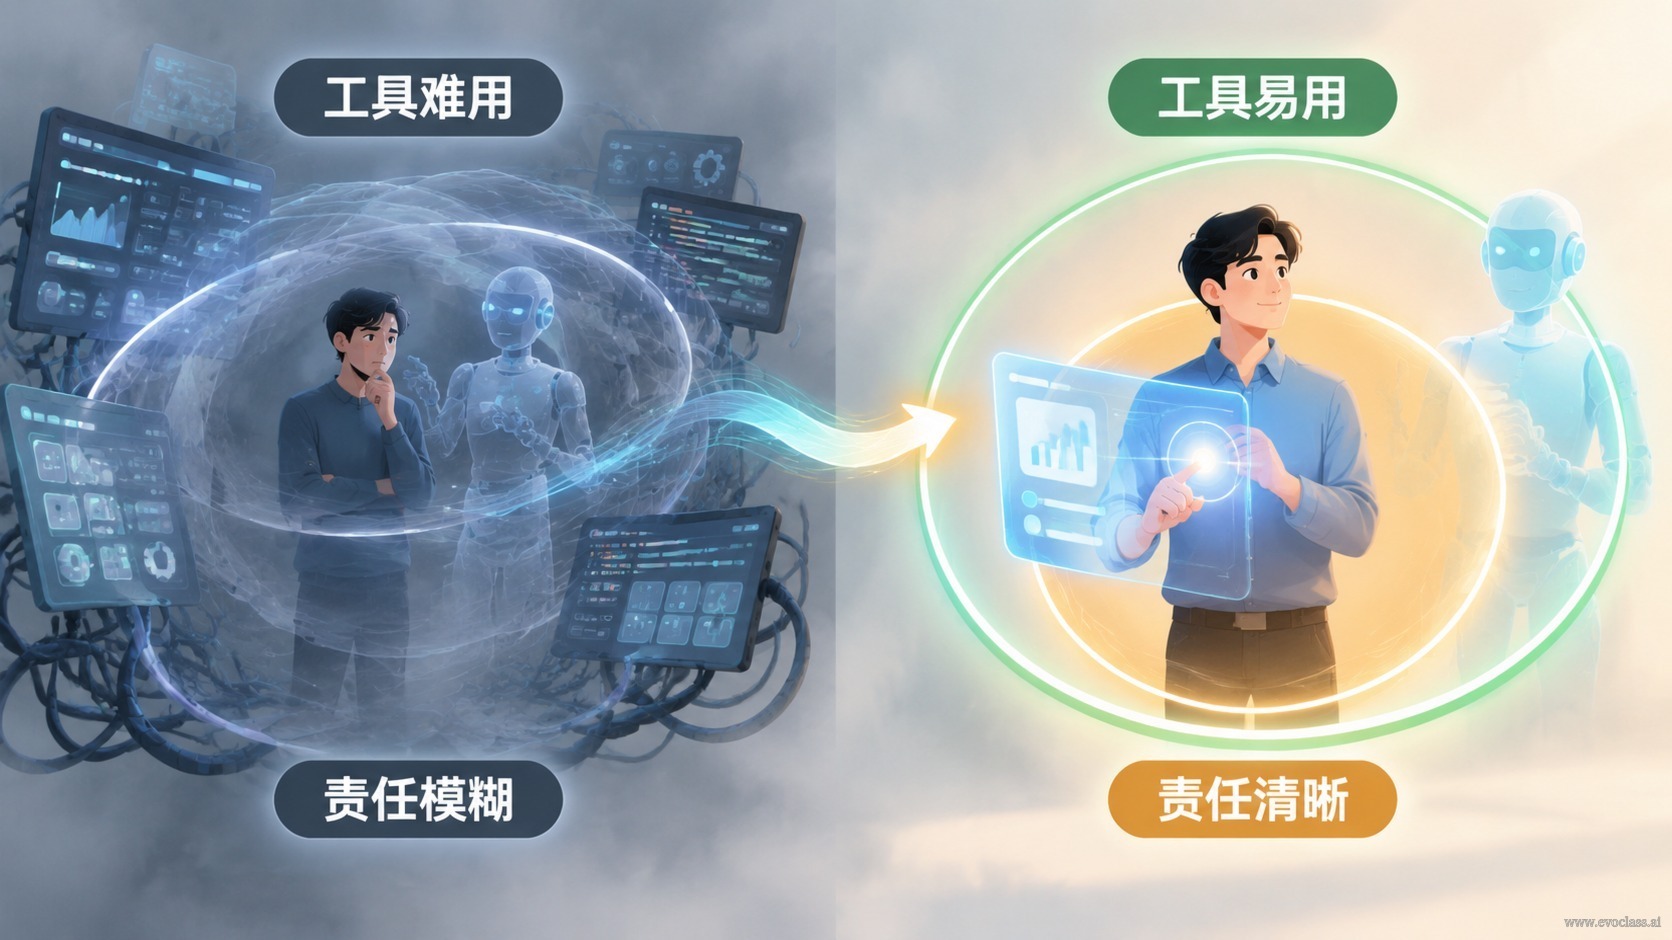
当 AI 与 EvoX 把“想法 → 代码 → 实验”的执行成本压到极低时,最容易出现的错觉是:判断也变得廉价了。事实恰恰相反——工具越容易使用,人的责任越清晰。模型可以迅速把想法变成可运行的候选实现,却不能替研究者决定这个想法是否值得研究、目标是否准确、比较是否公平。
责任上移:从实现到定义与裁决
- 执行成本下降 ≠ 判断成本消失:AI 与 EvoX 加速代码生成与实验循环,但问题选择、目标定义、评价标准仍由人承担。能跑通只是一份候选修改,不等于科学结论成立。
- 三类不可外包的判断:问题是否值得研究;目标是否准确;比较是否公平。这三者是科学效度的前置条件,也是自动化系统无法替代的裁决点。
- 责任边界随自动化显影:工具越强,越要明确哪些决策由 Agent 提议、哪些必须由人批准、哪些验收标准不可妥协。Genesis 的验收网关把这条边界工程化——候选修改必须通过编译、测试、行为检查与上层验收,才能进入项目历史。
结果有效性优先于运行成功
在多目标 EvoX 实验中,Agent 可以快速生成候选方案、批量调参并画出漂亮的收敛曲线;但“目标函数是否代表真实需求、候选多样性是否被单一指标掩盖、失败模式是否被选择性展示”,必须由研究者逐一审查。工具真正的价值,是让低价值实现更快被淘汰,让高价值判断更早成为瓶颈——这也正是研究者专业性的落点。
图灵提示
前方有许多事要完成:Code is cheap. Taste matters. 核心能力是提出关键问题,并以可复现的方式把控结论的有效性——研究者的品味,决定技术便利最终转化为何种科学价值。
人机协作责任边界
该图说明人机协作的责任边界:AI 与 EvoX 压缩的是想法到代码再到实验的执行成本,而问题是否值得研究、目标是否准确、比较是否公平仍由人裁决。候选修改须通过编译、测试、行为检查与上层验收的网关,才能进入项目历史,结果有效性优先于运行成功。
人机协作责任边界
该图说明人机协作的责任边界:AI 与 EvoX 压缩的是想法到代码再到实验的执行成本,而问题是否值得研究、目标是否准确、比较是否公平仍由人裁决。候选修改须通过编译、测试、行为检查与上层验收的网关,才能进入项目历史,结果有效性优先于运行成功。