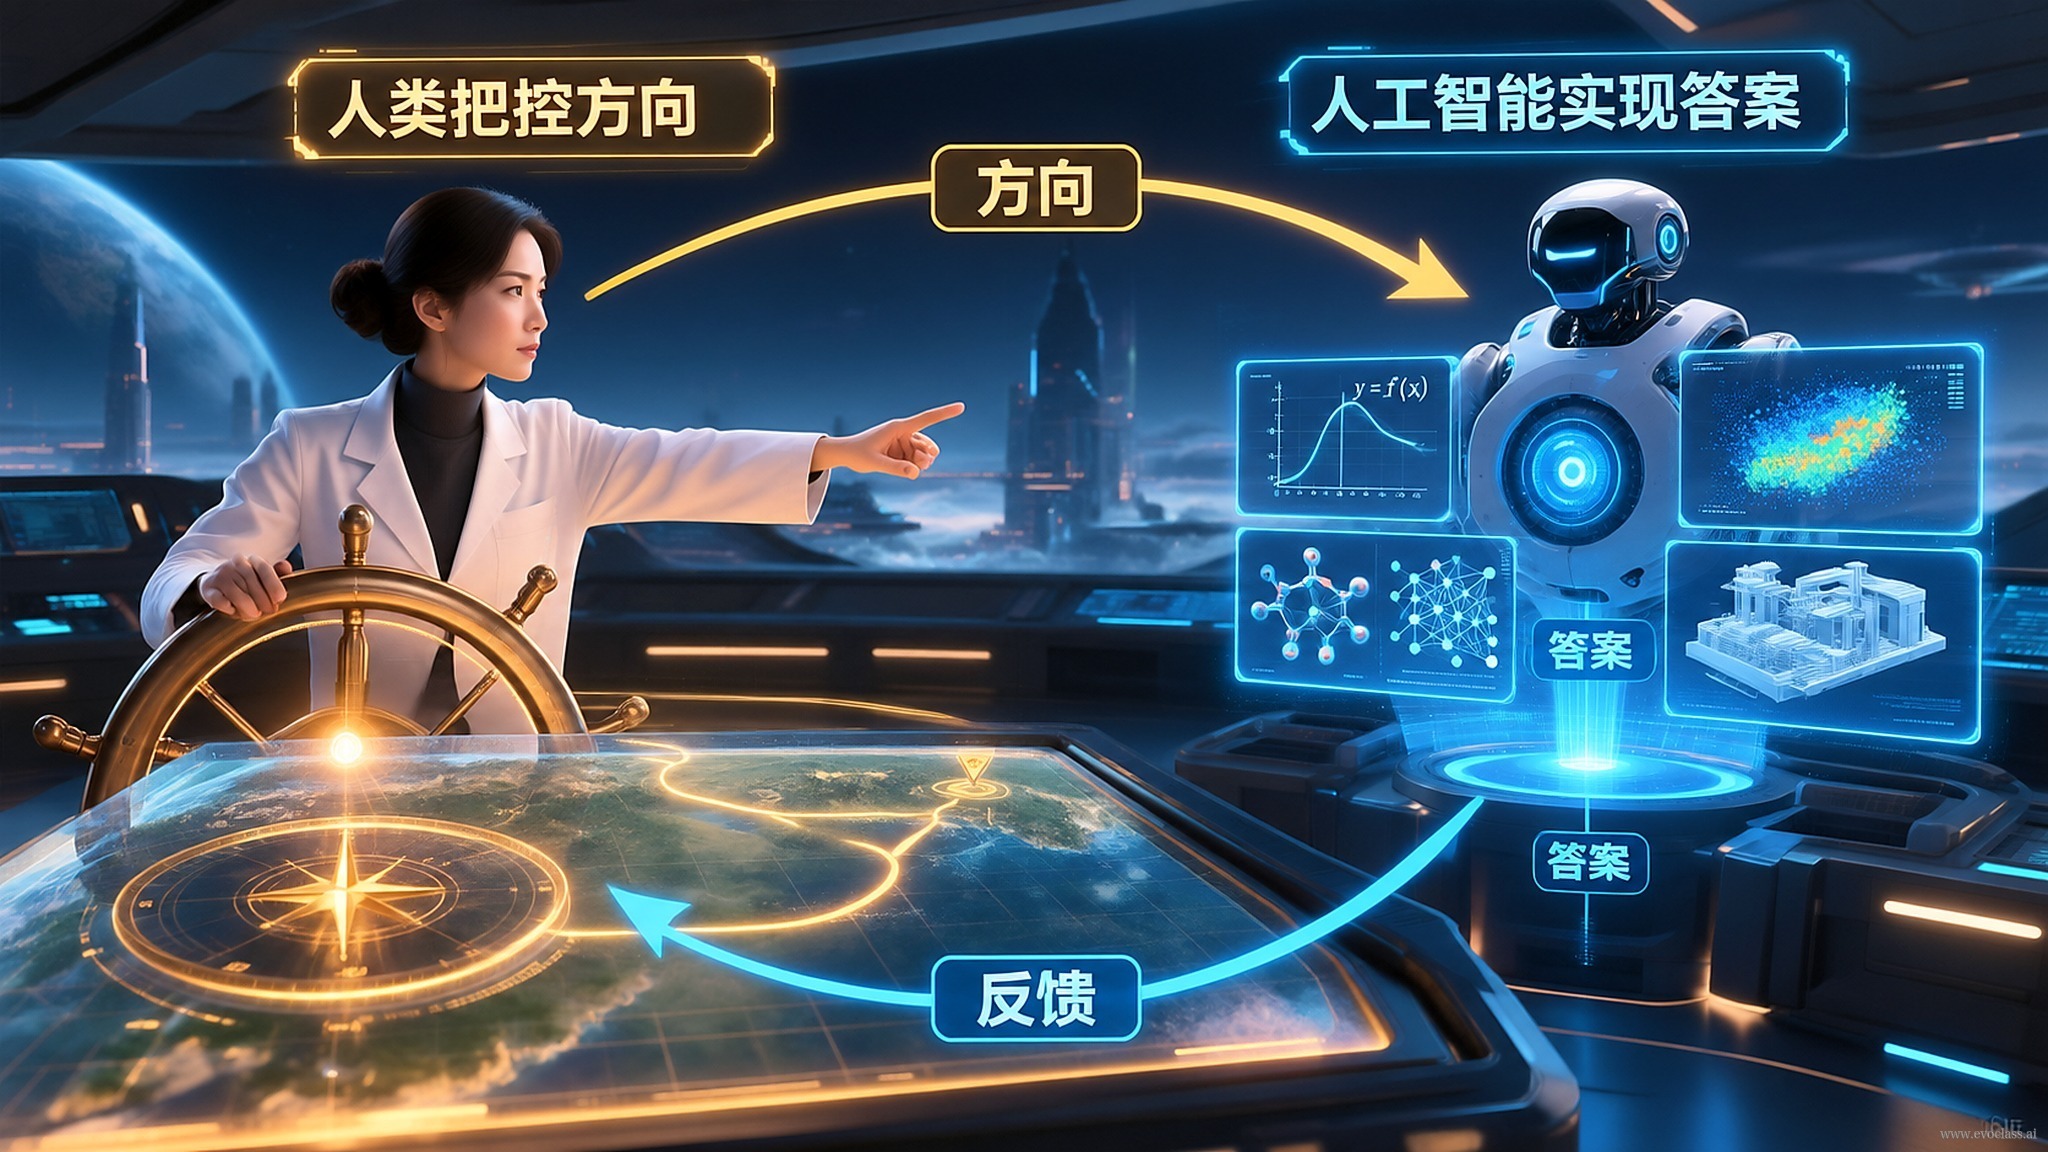
在真实的科研与工程系统里,AI 最被低估的能力不是“想得更深”,而是把实现与探索的带宽扩展到人类无法企及的规模。人机分工的本质因此可以画成一条清晰的分界线:把实现与探索交给 AI,把方向与判断交给研究者。AI 快速生成答案、批量运行实验、搜索候选解并反馈结果;人类决定什么问题值得回答、什么证据值得相信,并确保结果具有真正的科学意义。
AI 一侧:把实现成本压到接近于零
- 快速实现答案:一旦问题与评价标准被明确下来,AI 能在很短时间内给出可运行、可检验的方案与解释,实现不再是瓶颈。
- 批量运行实验:同一套流程可以并行铺开成百上千次试验,让“试错”从稀缺资源变成常规操作。
- 搜索候选解并反馈:在巨大的搜索空间中生成、筛选并回收结果,把探索的触角伸到人力达不到的地方。
人类一侧:把判断成本留在自己手里
- 提出关键问题:决定什么问题值得回答,而不是顺手去回答一个容易回答的问题。
- 设定目标、约束与评价标准:检查优化目标、约束条件与评价指标是否真实刻画了现实问题。
- 判断证据是否可信:区分“跑得通的结果”与“可靠的结果”,识别过拟合、数据泄漏与指标造假。
- 科学意义验收:最终交付的不是更多数字,而是科学上站得住脚、值得继续投入的结论。
为什么必须形成闭环
两侧通过“结果上行、标准下行”耦合在一起:AI 把候选答案与实验反馈推给研究者,研究者把目标、约束与验收标准交回给 AI。闭环的价值在于AI 扩展探索带宽,人类把控方向与验收标准,任何一侧缺席都会失效——只有 AI 会得到大量无意义的结果;只有人类则探索带宽受限。以多目标演化探索为例,AI 可以自动生成并运行大量候选方案,而研究者决定优化目标、约束条件和评价指标是否反映真实问题,并筛选出科学上可信、值得继续探索的方向。
常见误区
把评价标准也一并交给 AI 自动决定。这样系统会非常高效地优化一个并不反映真实科学问题的目标,产出大量“看起来合理”却毫无意义的结果。凡是会改变“什么算好”的决策,都必须留在人类一侧。
自检:回想你最近一次实验,其中“这个问题要不要做”“什么算成功”这两个判断,分别是谁做出的?如果答案都是模型,那么分工已经失衡。
人机分工闭环
这张分工模型把 AI 一侧归为快速实现答案、批量运行实验、搜索候选解并反馈结果,把人类一侧归为提出关键问题、设定目标约束与评价标准、判断证据可信并验收科学意义。两侧通过结果上行、标准下行形成闭环,若评价标准也交给 AI,系统就会高效优化一个并不反映真实科学问题的目标。
人机分工闭环
这张分工模型把 AI 一侧归为快速实现答案、批量运行实验、搜索候选解并反馈结果,把人类一侧归为提出关键问题、设定目标约束与评价标准、判断证据可信并验收科学意义。两侧通过结果上行、标准下行形成闭环,若评价标准也交给 AI,系统就会高效优化一个并不反映真实科学问题的目标。