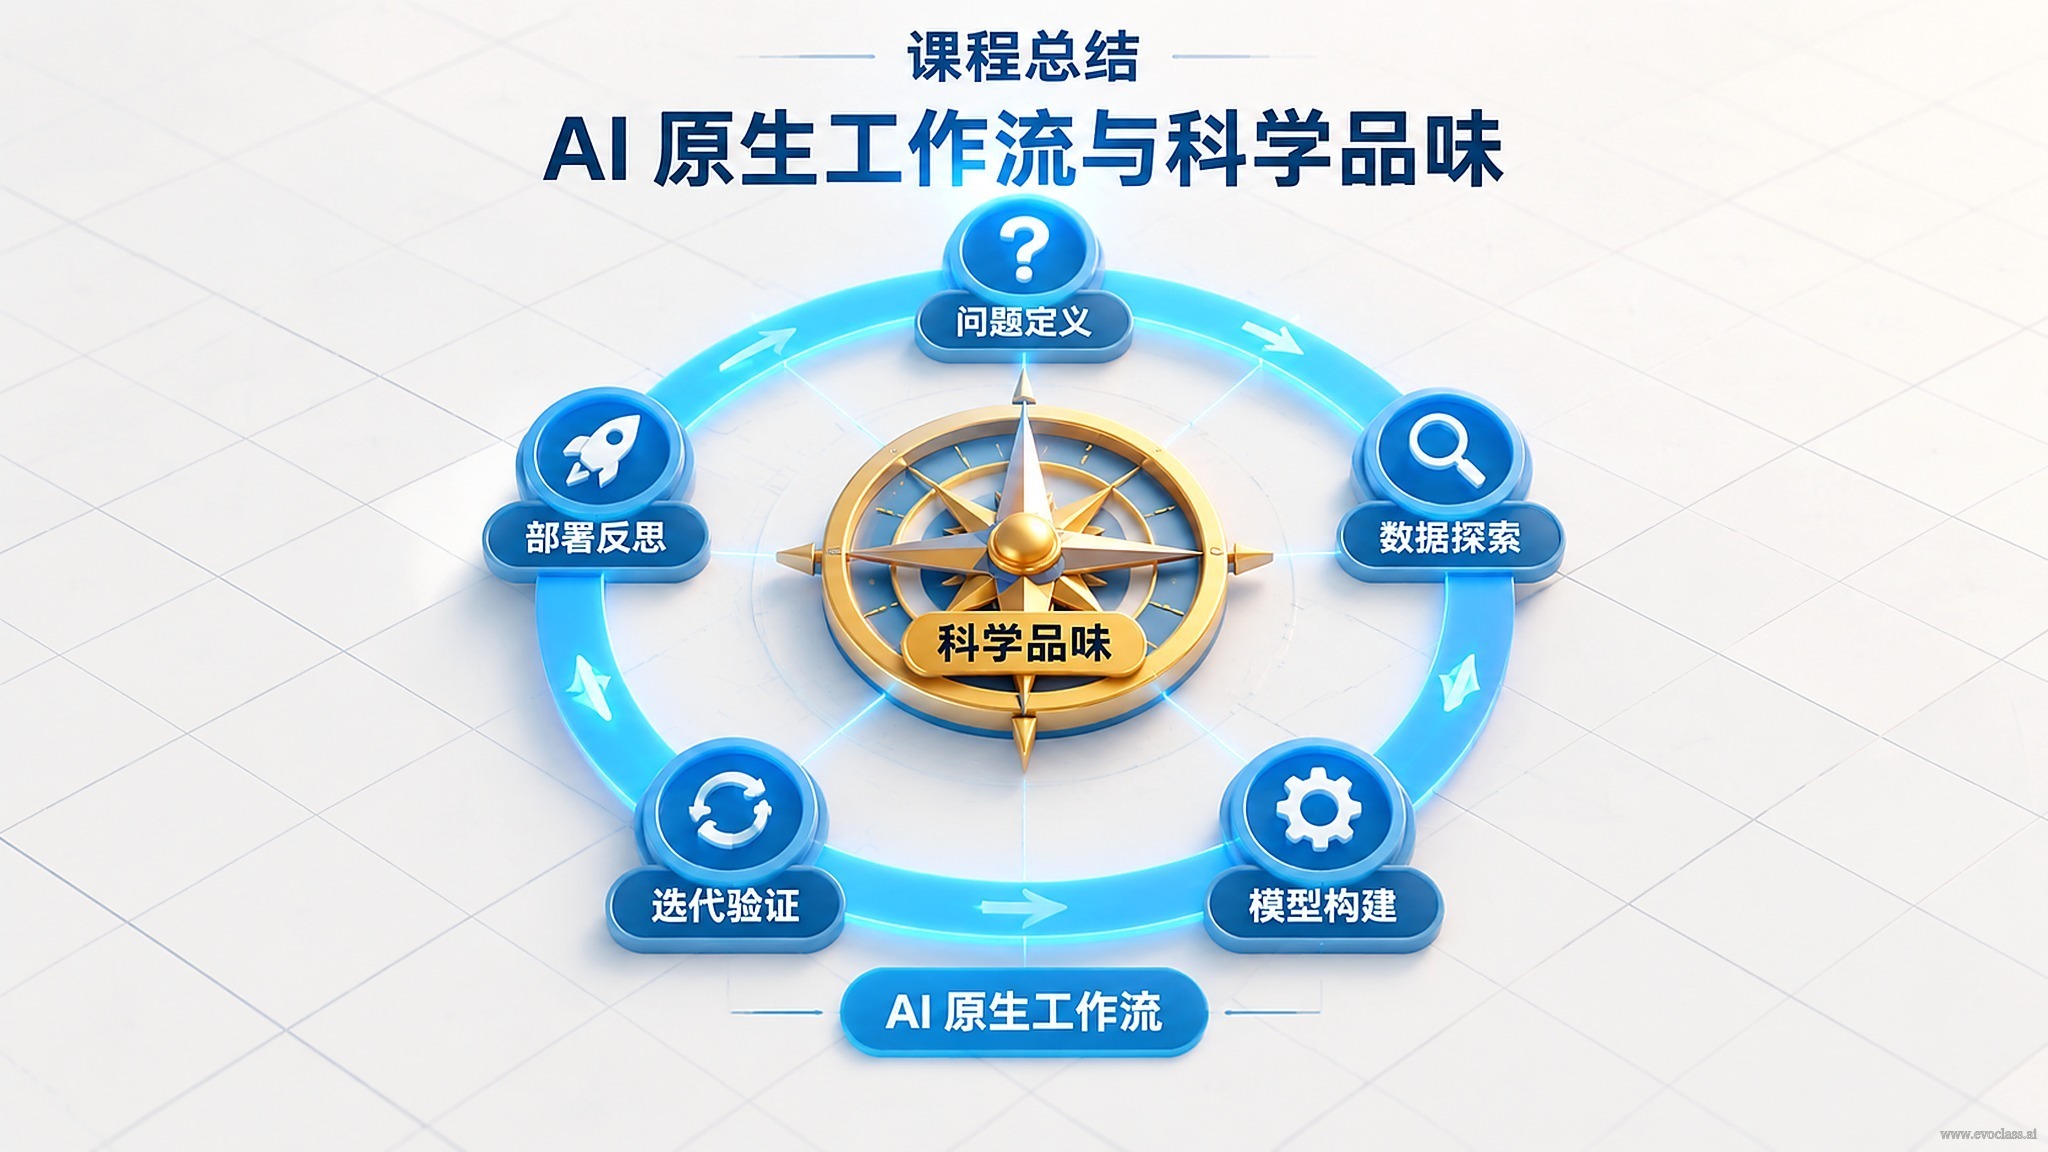
本页作为全课收束,把 EvoX 的 AI 原生工作流 与研究者不可替代的 科学品味 收敛为同一个结论:当工具把“实现答案”的成本压到极低时,“定义什么值得做、判断什么结果可信”就成为科研价值的分水岭。
一、AI 原生工作流:从想法到可运行实验的最短路径
AI 原生工作流以自然语言对话为入口,驱动 EvoX 的全链路实验:配置环境 → 构建问题 → 运行演化 → 结果可视化与分析。它压缩的不是实验本身,而是从“想法”到“第一次可运行实验”之间的路径成本。过去需要数天搭建的脚本骨架、参数接口与绘图代码,如今可以在一次对话中成形,研究者因此拥有了更高的实验迭代频率。
二、责任随便捷性上升
工具越容易使用,人的责任反而越清晰。自动化转移的是执行负担,而不是判断责任。当 AI 在数分钟内产出一组候选方案时,“这组多目标权衡是否合理”“这个指标提升是否可信”“下一步该探索哪个方向”并没有随之被解答,反而因为产出变快而更频繁地摆到研究者面前。便捷性提高了试错吞吐量,也同等放大了错误决策的传播速度。
三、科学品味的落点
科学品味不是抽象的审美,它具体落在以下可指认的环节:
- 问题定义:决定研究什么、放弃什么,即“什么值得做”。
- 目标与约束设定:把模糊的研究意图翻译成可优化的目标函数与硬性约束。
- 多目标权衡取舍:在收敛速度、多样性、鲁棒性、成本之间给出可辩护的偏好。
- 结果可信度判断:区分“跑出来了”和“结论站得住”。
- 演化方向设定:决定下一轮探索哪里,而不是被动接受当前最优。
这些环节无法被工具替代,因为它们不是计算问题,而是价值与判断问题。
四、批判性思维的落点
对 AI 输出应保持结构化的验证与质疑,至少覆盖四个问题:
- 假设是否成立?AI 往往默默补齐了它未言明的前提,而这些前提可能不适用于你的问题。
- 指标是否被误读?指标提升可能来自数据泄漏、评估口径变化,或过拟合于测试集。
- 结果能否复现?随机种子、并行调度、依赖版本都会影响可复现性。
- 边界与失效模式是否被检验?在极端约束、稀疏数据或高维情形下,方案是否依然成立。
五、人机分工与持续演化
本课的分工原则可以压缩成一句话:AI 实现答案,人类把控方向;Code is cheap. Taste matters. 前者是产能问题,后者是方向与价值问题。放到项目级与系统级的持续演化中同样成立:无论自动化程度多高,验收标准与演进方向仍需由人设定;一旦长期缺失这种判断,品味上的缺口会被时间放大成难以偿还的技术债。工具让“做出来”变得便宜,正因如此,“做什么、信什么”才成为真正的分水岭。
一句话带走
当实现成本趋近于零时,稀缺的不是代码,而是判断力:定义问题、设定目标、权衡取舍、验证结果。工作流熟练度决定你能跑多快,科学品味与批判性思维决定你跑的方向对不对。
全课核心总结图
图表把全课两条主线并置:AI 原生工作流负责从想法到可运行实验的快速实现,科学品味与批判性思维负责问题定义、目标设定、多目标权衡、结果验证和演化方向判断;结论是工具让实现变便宜,人的判断力才是科研价值的分水岭。
全课核心总结图
图表把全课两条主线并置:AI 原生工作流负责从想法到可运行实验的快速实现,科学品味与批判性思维负责问题定义、目标设定、多目标权衡、结果验证和演化方向判断;结论是工具让实现变便宜,人的判断力才是科研价值的分水岭。