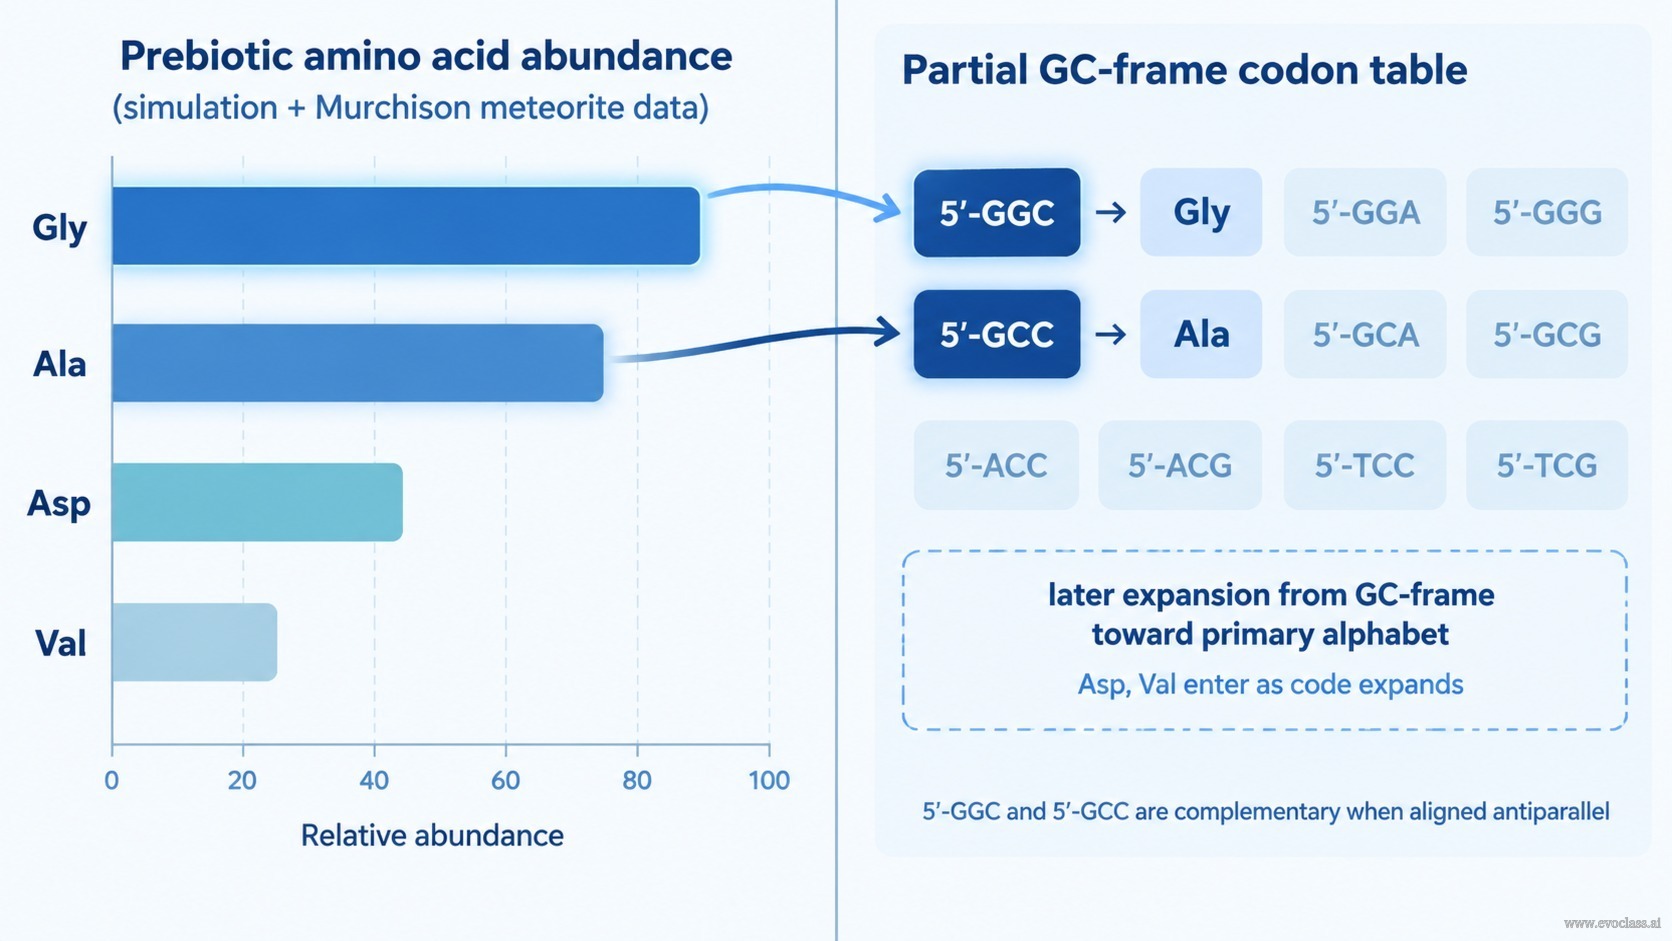
原始スープにおいて、アミノ酸の存在量は一様ではありませんでした。ミラー型合成とマーチソン隕石の分析は、一貫した順位に収束します: グリシン > アラニン > アスパラギン酸 > バリン。この順序は単なる記述ではなく、最初期の遺伝暗号に対する条件付きの選択論理を提供します。最初の符号化時代がGCに富む鋳型を用いたのであれば、最も豊富なアミノ酸が最初に動員されるはずです。最も豊富な2つのアミノ酸——グリシンとアラニン——は、最初の2つのGCフレームコドンに割り当てられます: 5′-GGC → Gly および 5′-GCC → Ala。これらの割り当ては、存在量リストの上位を非対称なGCパターンの開始点に置くものであり、GCに富む複製体制と一致します。
なぜ最初にGCに富むのか?
GCの組み合わせから始めることを支持する4つの論拠があります:(i) アダプター–メッセンジャー相互作用の安定性、(ii) 複製の正確性(いずれもGCを有利にする)、(iii) 翻訳におけるコンマ不要の読み取り(非対称なGCパターンを必要とする)、そして (iv) 最も豊富な原始アミノ酸との対応です。最初の2つのコドン、5′-GGCと5′-GCCは、逆平行に整列させると相補的であり、その中心的な役割を強化します。
AspとValは存在量順序でその次に位置します。これらは厳密なGCフレームにおける初期の割り当てとしてではなく、暗号が最小限のGCフレームから一次アルファベットへと拡張するにつれて関連してきます。
条件付き推論: この再構成は、存在量が初期の機能的利用可能性と相関すること、そしてGCに富む鋳型が最初の符号化時代を支配していたことを前提としています。代替シナリオ——ランダムなコドン割り当てや、コドンとアミノ酸の間の直接的な化学的親和性——は論理的に依然として可能であり、独立した実験的または系統学的検証を必要とします。
存在量からコドンへの対応付け2パネル構成の図:左側では、シミュレーションとマーチソン隕石のデータに基づく原始アミノ酸の存在量が順位付きの棒グラフで示されています(Gly > Ala > Asp > Val)。右側では、部分的なコドン表が最初のGCフレームコドンである5′-GGC(Gly)と5′-GCC(Ala)を強調し、AspとValは後の拡張項目として示されています。