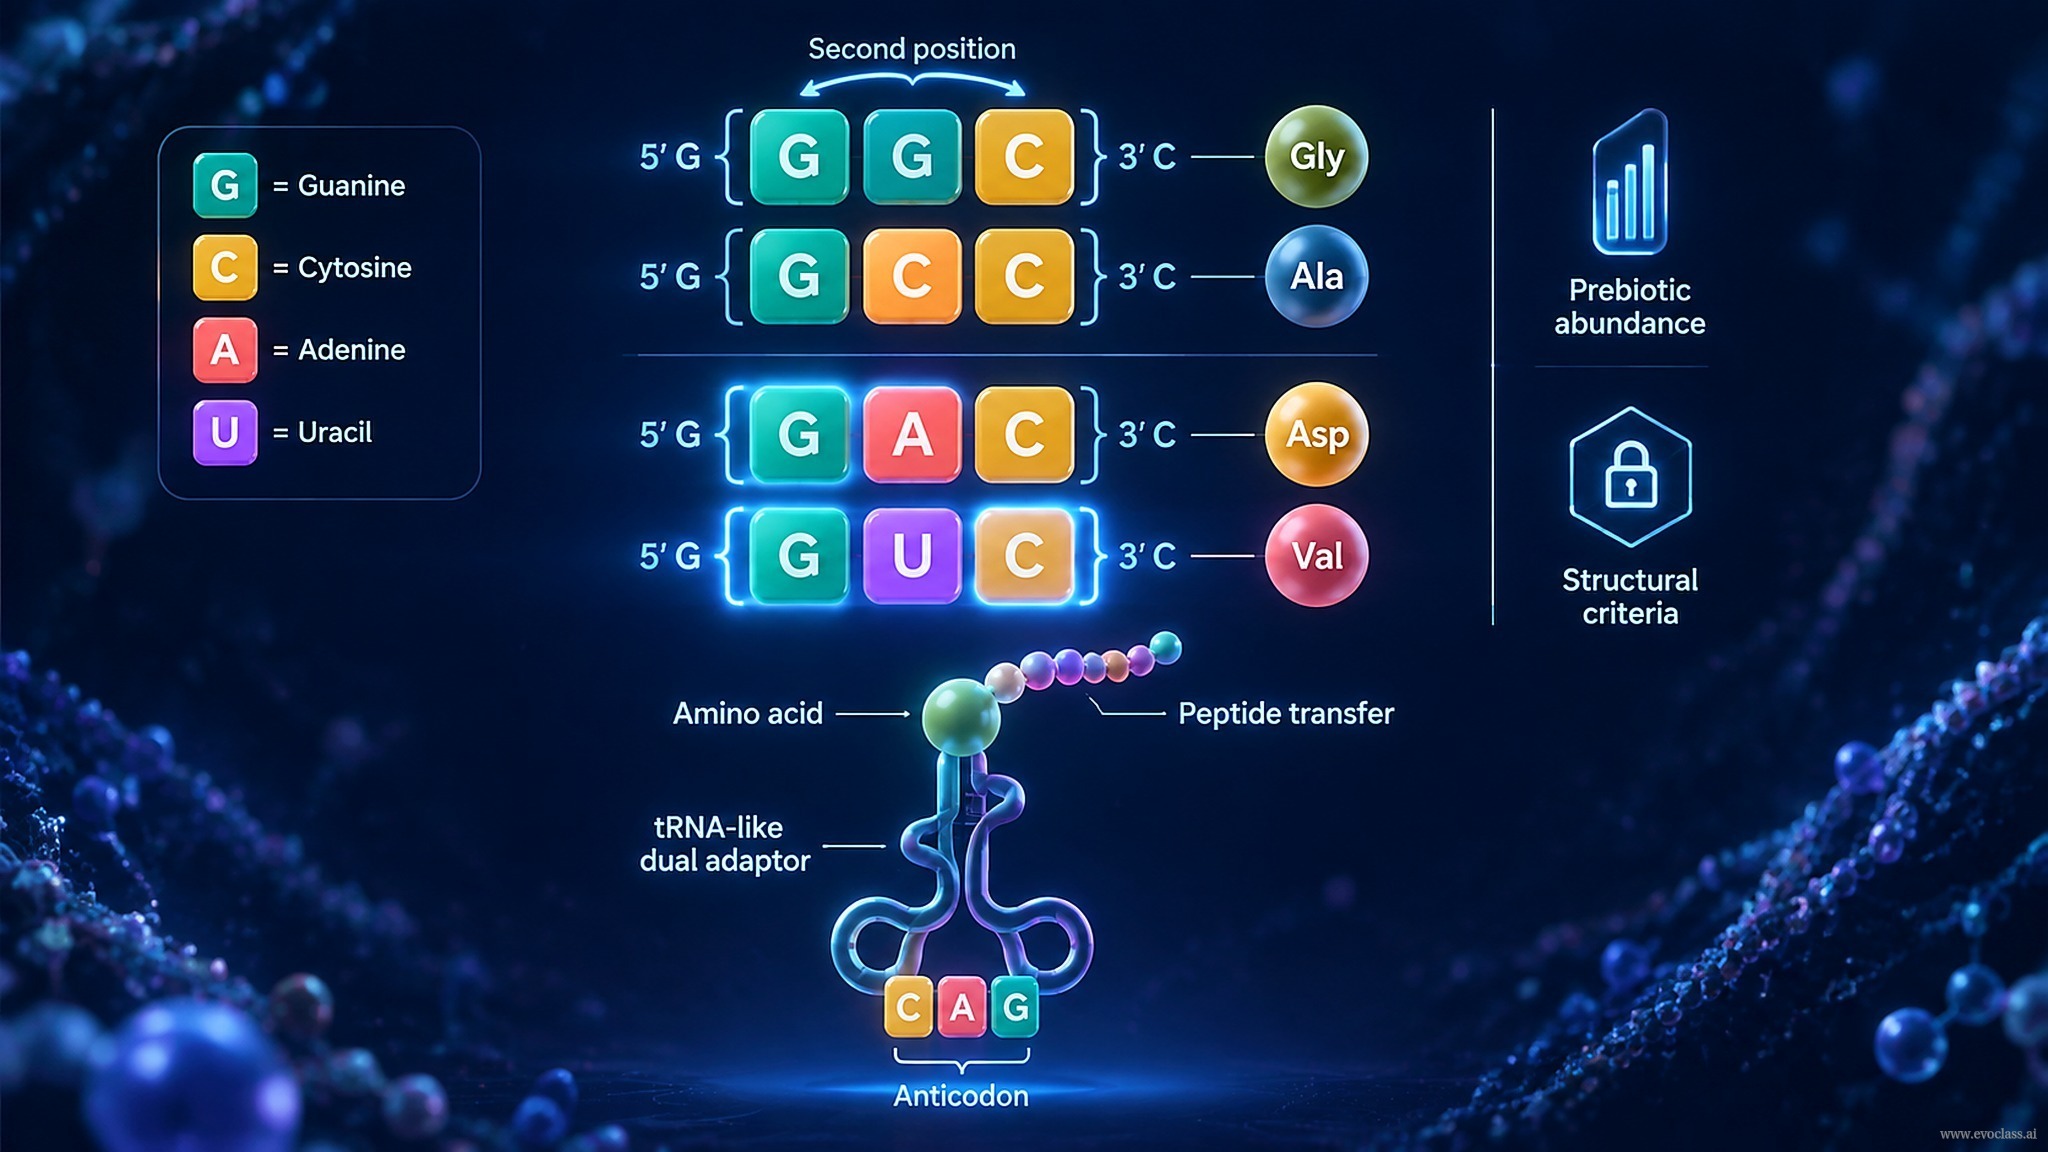
원시 유전 암호는 어떻게 2개 코돈의 원시 코드에서 1차 아미노산 알파벳으로 확장되는가? 이 슬라이드는 코드의 확장을 제약된 단계적 과정으로 다루며, 64개 코돈 전체 표로의 갑작스러운 도약으로 보지 않는다. 출발점은 앞서 G–C가 풍부한 복제, 높은 충실도, 일관된 콤마-프리 읽기틀을 위해 선택된 한 쌍인 GGC 와 GCC이다. 첫 번째 확장은 GAC 와 GUC를 추가하여 아스파르트산 (Asp) 와 발린 (Val) 을 초기 코드에 배정한다. 정규적으로: GGC → Gly, GCC → Ala, GAC → Asp, GUC → Val.
이 확장이 조합적으로 단순한 이유
초기 코돈 네 개는 모두 고정된 틀을 공유한다: 5′ G ... 3′ C. 오직 두 번째 위치 만 변하며 G, C, A, U를 표본화한다. 이는 간결한 조합 경로를 제공한다: G–C 틀과 그 복제 충실도가 확립되면, 단일 위치를 변화시켜 새로운 배정을 탐색할 수 있다. 따라서 GAC와 GUC로의 확장은 이미 견고한 틀 안에서 자연스러운 다음 단계이다.
1차 알파벳을 제한하는 것
모든 아미노산이 참여할 수 있는 것은 아니다. 1차 집합은 전생물적 풍부도 와 구조적 기준에 의해 제약된다: 충분히 흔하고 적합한 곁사슬 화학을 가지며 RNA 어댑터, 활성화, 펩타이드 전달과 호환되는 아미노산만이 코드에 들어갈 수 있다. 그럴듯한 번역의 기원은 또한 tRNA만큼 큰 재현 가능한 RNA 분자가 이중 어댑터와 메신저로 작용할 수 있어야 하고, 원시적 펩타이드 전달 기구와 배정을 유지할 만큼의 충실도가 필요하다.
하이퍼사이클과의 결합
코드 확장은 결합된 분자 선택 문제이다. 새로운 코돈은 번역-결합 하이퍼사이클을 개선하거나 최소한 불안정하게 만들지 않아야 하며, 전체 시스템은 오류 임계값 한계 내에 머물러야 한다. 이 슬라이드는 첫 두 코돈에서 1차 알파벳으로 가는 다리이며, 이후의 완전한 코돈 배정표나 번역의 완전한 합성은 아직 다루지 않는다.
코돈 틀 확장초기 코드는 두 개의 코돈(GGC, GCC)에서 GAC와 GUC를 추가하여 네 개로 확장된다. 네 개 모두 고정된 5′ G와 3′ C 틀을 공유하므로 두 번째 위치만 변하며 G, C, A, U를 표본화한다. 새로운 아미노산의 진입은 전생물적 풍부도와 구조적 기준으로 필터링된다.