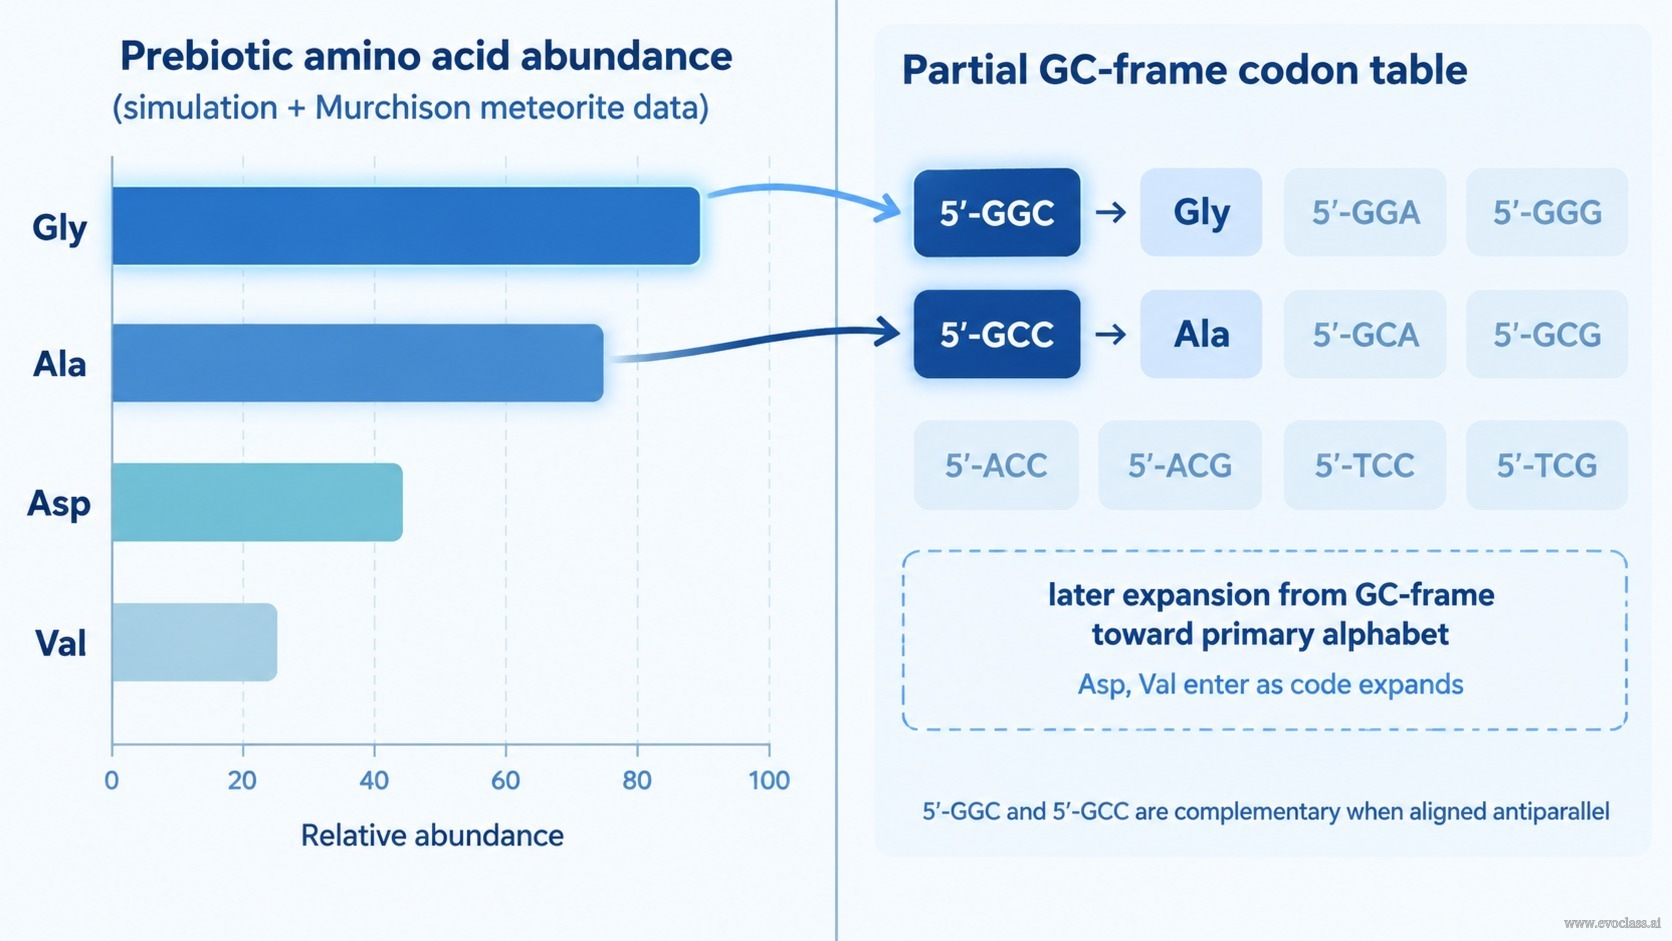
Na sopa pré-biótica, as abundâncias dos aminoácidos não eram uniformes. A síntese do tipo Miller e as análises do meteorito de Murchison convergem numa classificação consistente: glicina > alanina > ácido aspártico > valina. Esta ordem não é meramente descritiva; fornece uma lógica de seleção condicional para o código genético mais primitivo. Se a primeira época de codificação usou moldes ricos em GC, então os aminoácidos mais abundantes deveriam ser recrutados primeiro. Os dois aminoácidos mais abundantes — glicina e alanina — são atribuídos aos dois primeiros codões no referencial GC: 5′-GGC → Gly e 5′-GCC → Ala. Estas atribuições colocam o topo da lista de abundância no início de um padrão GC assimétrico, consistente com um regime de replicação rico em GC.
Porquê começar por sequências ricas em GC?
Quatro argumentos apoiam começar com combinações de GC: (i) a estabilidade da interação adaptador–mensageiro, (ii) a fidelidade de replicação, ambas favorecendo o GC; (iii) a leitura sem vírgulas na tradução, que exige um padrão GC assimétrico; e (iv) a correspondência com os aminoácidos pré-bióticos mais abundantes. Os dois primeiros codões, 5′-GGC e 5′-GCC, são complementares quando alinhados em antiparalelo, reforçando o seu papel central.
Asp e Val ocupam a posição seguinte na ordem de abundância. Tornam-se relevantes à medida que o código se expande do referencial GC minimal para o alfabeto primário, e não como atribuições iniciais no referencial GC estrito.
Inferência condicional: Esta reconstrução assume que a abundância se correlaciona com a disponibilidade funcional primitiva e que os moldes ricos em GC dominaram a primeira época de codificação. Cenários alternativos — atribuição aleatória de codões ou afinidade química direta entre codões e aminoácidos — permanecem logicamente possíveis e exigem testes experimentais ou filogenéticos independentes.
Mapeamento Abundância–CodãoUm diagrama de dois painéis: à esquerda, barras ordenadas mostram a abundância de aminoácidos pré-bióticos a partir de simulações e dados de Murchison (Gly > Ala > Asp > Val); à direita, uma tabela parcial de codões destaca os primeiros codões no referencial GC, 5′-GGC (Gly) e 5′-GCC (Ala), com Asp e Val indicados como entradas de expansão posterior.