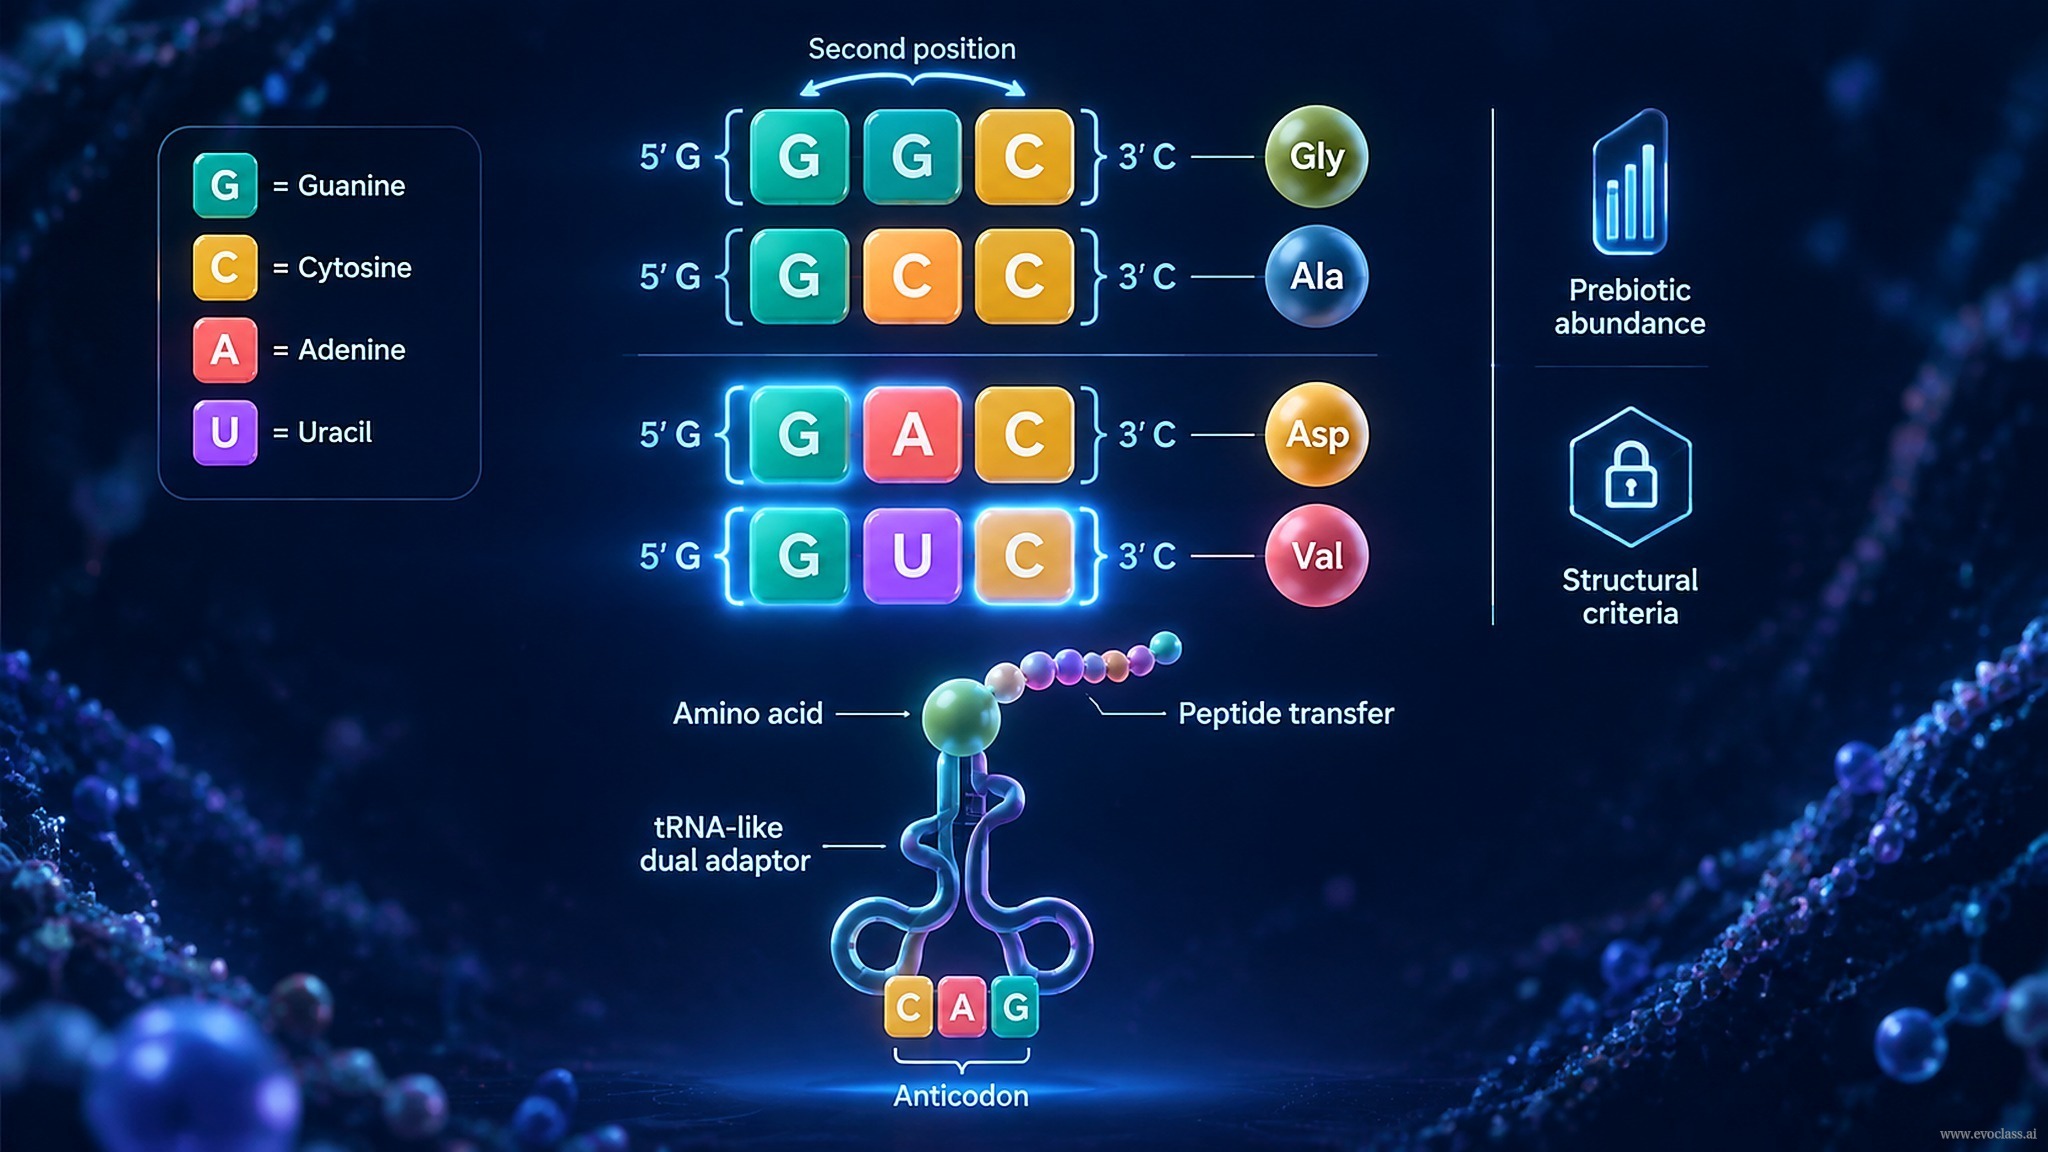
รหัสพันธุกรรมยุคแรกเริ่มเติบโตจากโปรโตโค้ดสองโคดอนไปสู่ชุดตัวอักษรกรดอะมิโนหลักได้อย่างไร สไลด์นี้อธิบายการขยายรหัสว่าเป็น กระบวนการทีละขั้นที่มีข้อจำกัดไม่ใช่การกระโดดไปสู่ตาราง 64 โคดอนแบบทันที จุดเริ่มต้นคือคู่ GGC และ GCCซึ่งถูกคัดเลือกไว้ก่อนหน้านี้จากการจำลองแบบที่อุดมด้วย G–C ความแม่นยำสูง และกรอบการอ่านแบบไม่มีเครื่องหมายคั่นที่สอดคล้องกัน การขยายครั้งแรกเพิ่ม GAC และ GUCโดยกำหนดให้ กรดแอสปาร์ติก (Asp) และ วาลีน (Val) เข้าสู่รหัสยุคแรก ตามรูปแบบมาตรฐาน: GGC → Gly, GCC → Ala, GAC → Asp, GUC → Val
เหตุใดการขยายนี้จึงเรียบง่ายในเชิงการจัดหมู่
โคดอนยุคแรกทั้งสี่ใช้กรอบคงที่ร่วมกัน: 5′ G ... 3′ C มีเพียง ตำแหน่งที่สอง เท่านั้นที่เปลี่ยน — สุ่มตัวอย่าง G, C, A และ U สิ่งนี้ให้เส้นทางการจัดหมู่ที่กระชับ เมื่อกรอบ G–C และความแม่นยำในการจำลองแบบถูกกำหนดขึ้นแล้ว การกำหนดค่าใหม่สามารถสำรวจได้โดยการแปรผันเพียงตำแหน่งเดียว การขยายไปยัง GAC และ GUC จึงเป็นขั้นตอนถัดไปตามธรรมชาติภายในกรอบที่มีความแข็งแกร่งอยู่แล้ว
อะไรเป็นตัวจำกัดชุดตัวอักษรหลัก
ไม่ใช่ทุกกรดอะมิโนที่จะเข้าร่วมได้ ชุดหลักถูกจำกัดด้วย ความอุดมสมบูรณ์ก่อนกำเนิดชีวิต และ เกณฑ์ทางโครงสร้าง: มีเพียงกรดอะมิโนที่พบได้ทั่วไปเพียงพอและมีเคมีของสายข้างที่เหมาะสม ตลอดจนความเข้ากันได้กับตัวปรับอาร์เอ็นเอ การกระตุ้น และการถ่ายโอนเพปไทด์ เท่านั้นที่จะเข้าสู่รหัสได้ ต้นกำเนิดของการแปลรหัสที่เป็นไปได้ยังต้องอาศัยโมเลกุลอาร์เอ็นเอที่จำลองแบบได้ขนาดใหญ่เท่า tRNA ซึ่งทำหน้าที่เป็นทั้งตัวปรับคู่และตัวนำสาร รวมถึงกลไกการถ่ายโอนเพปไทด์แบบดั้งเดิมและความแม่นยำที่เพียงพอต่อการรักษาการกำหนดค่า
การเชื่อมโยงกับไฮเปอร์ไซเคิล
การขยายรหัสเป็นปัญหาการคัดเลือกเชิงโมเลกุลแบบเชื่อมโยง โคดอนใหม่ต้องปรับปรุงไฮเปอร์ไซเคิลที่เชื่อมโยงกับการแปลรหัส หรืออย่างน้อยต้องไม่ทำให้ไม่เสถียร และระบบทั้งหมดต้องอยู่ภายในขีดจำกัดของเกณฑ์ความคลาดเคลื่อน สไลด์นี้เป็นสะพานเชื่อมจากสองโคดอนแรกไปสู่ชุดตัวอักษรหลัก ยังไม่ครอบคลุมตารางการกำหนดโคดอนทั้งหมดในภายหลังหรือการสังเคราะห์การแปลรหัสแบบสมบูรณ์
การขยายกรอบโคดอนรหัสยุคแรกขยายจากสองโคดอน (GGC, GCC) เป็นสี่โคดอนโดยเพิ่ม GAC และ GUC ทั้งสี่ใช้กรอบ 5′ G และ 3′ C คงที่ร่วมกัน ดังนั้นมีเพียงตำแหน่งที่สองที่แปรผัน สุ่มตัวอย่าง G, C, A, U การเข้าสู่รหัสของกรดอะมิโนใหม่ถูกกรองด้วยความอุดมสมบูรณ์ก่อนกำเนิดชีวิตและเกณฑ์ทางโครงสร้าง