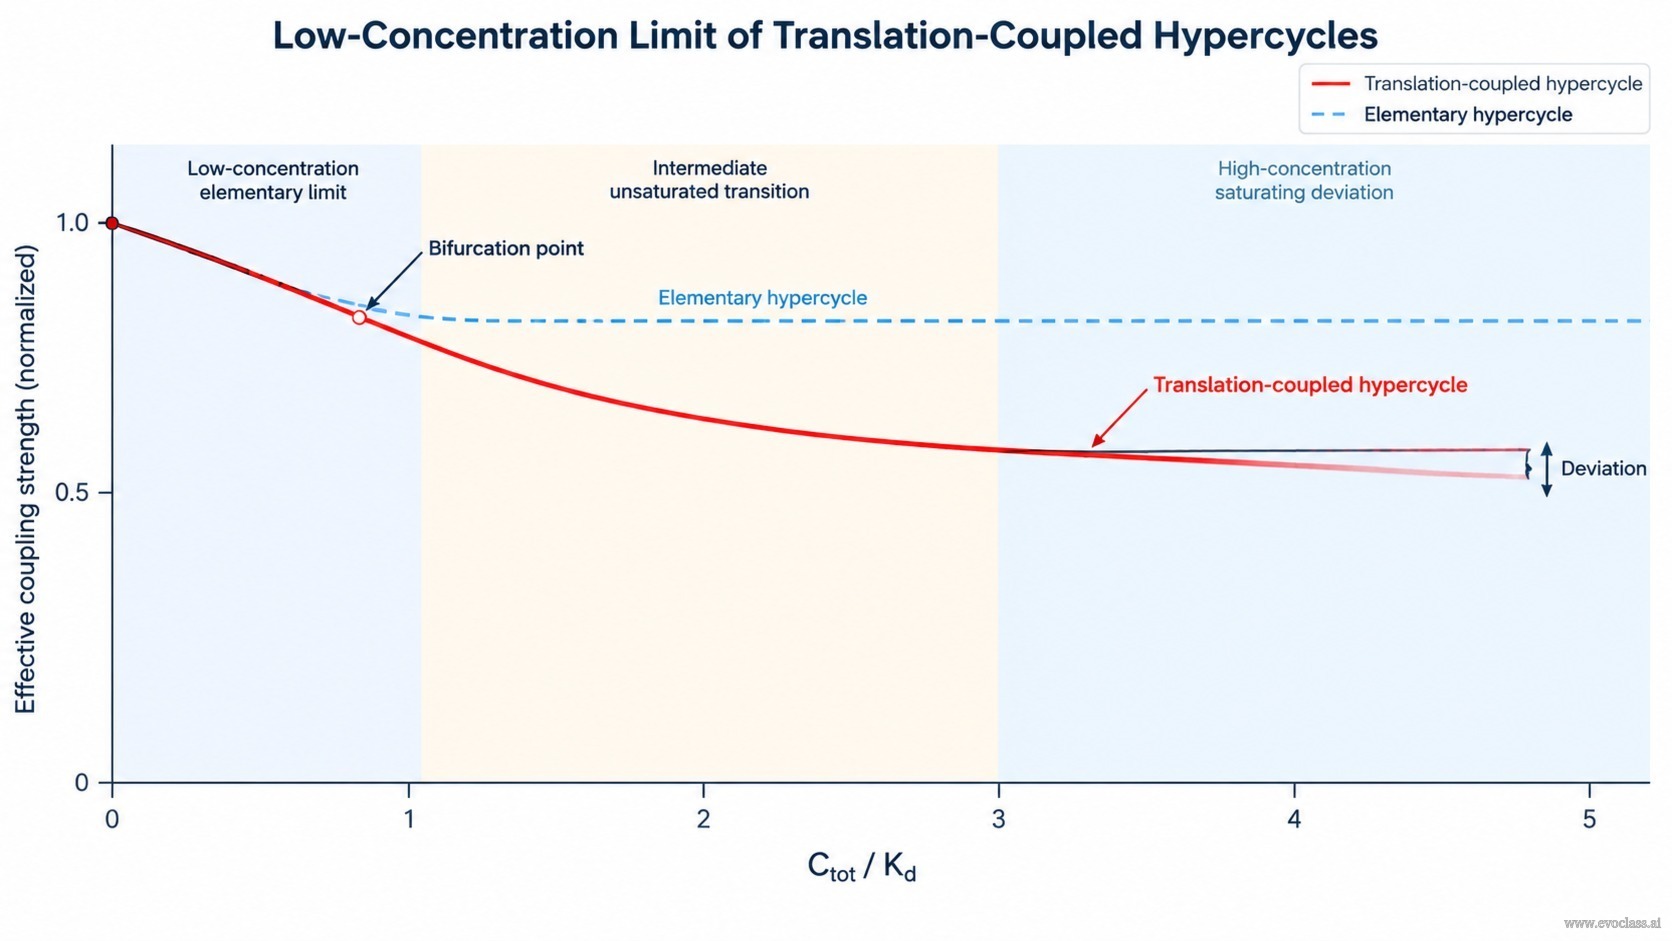
Trong một siêu chu trình liên kết dịch mã, mỗi khuôn mẫu RNA không chỉ được sao chép mà còn được dịch mã thành một polypeptide liên kết trở lại RNA thông qua sự hình thành phức hợp thuận nghịch. Bước liên kết đó, được đặc trưng bởi hằng số phân ly
Vì sao tổng nồng độ thấp làm đơn giản hóa động học
Khi tổng nồng độ RNA và polypeptide nhỏ hơn nhiều so với
- Các dạng tự do chiếm ưu thế. [phức hợp] nhỏ hơn nhiều so với [RNA] và [polypeptide], nên động học được dẫn dắt bởi các dạng tự do thay vì vật chất đã liên kết.
- Nồng độ phức hợp song tuyến. [phức hợp] ≈ [RNA][polypeptide]/Kd, tức là tỷ lệ với tích của hai nồng độ tự do thay vì chỉ tỷ lệ với một trong hai.
- Dòng xúc tác bậc hai. Vì phức hợp là chất xúc tác, dòng được trung gian kcat[RNA][polypeptide]/Kd ≈ (kcat/Kd)[RNA][polypeptide] là một số hạng tác dụng khối bậc hai — đúng dạng liên kết mà một siêu chu trình cơ sở sử dụng.
Hằng số tốc độ hiệu dụng và cấu trúc tô-pô được bảo toàn
Hằng số kết hợp và hằng số xúc tác chỉ xuất hiện thông qua tổ hợp của chúng, nên chúng có thể được gộp vào một hằng số tốc độ hiệu dụng duy nhất keff = kcat/Kd. Kết quả là một siêu chu trình cơ sở với các hệ số được tái chuẩn hóa. Điều quan trọng là cấu trúc tô-pô liên kết vòng được bảo toàn: mỗi thành viên vẫn xúc tác cho sự sao chép của thành viên kế tiếp quanh vòng, và dịch mã không tạo ra liên kết động học độc lập nào ở giới hạn này — nó chỉ tái định tỷ lệ các tốc độ. Đây là lý do các phân tích về điểm bất động, ổn định, chu trình giới hạn và ngưỡng sai sót được phát triển cho các siêu chu trình cơ sở có thể áp dụng trực tiếp cho các siêu chu trình liên kết dịch mã bất cứ khi nào điều kiện pha loãng được thỏa mãn, và chính điều này khiến phép rút gọn trở nên hữu ích cho lập luận về chọn lọc và ngưỡng sai sót.
Nơi phép rút gọn không còn đúng
Phép rút gọn mang tính tiệm cận, không phải là đồng nhất thức. Nó chỉ còn đúng khi sự hình thành phức hợp chưa bão hòa. Khi tổng nồng độ tăng tiến tới
Giới hạn nồng độ thấp của siêu chu trình liên kết dịch mãĐộ mạnh liên kết hiệu dụng của một siêu chu trình liên kết dịch mã được vẽ theo tổng nồng độ không thứ nguyên C_tot/K_d. Ở các giá trị thấp, đường liền nét của siêu chu trình liên kết dịch mã hòa vào đường nét đứt tham chiếu siêu chu trình cơ sở, vì các phức hợp RNA-polypeptide thưa thớt, chưa bão hòa cho dòng xúc tác song tuyến với hằng số hiệu dụng k_cat/K_d; khi nồng độ tăng, các phức hợp bão hòa và hai đường tách khỏi nhau.