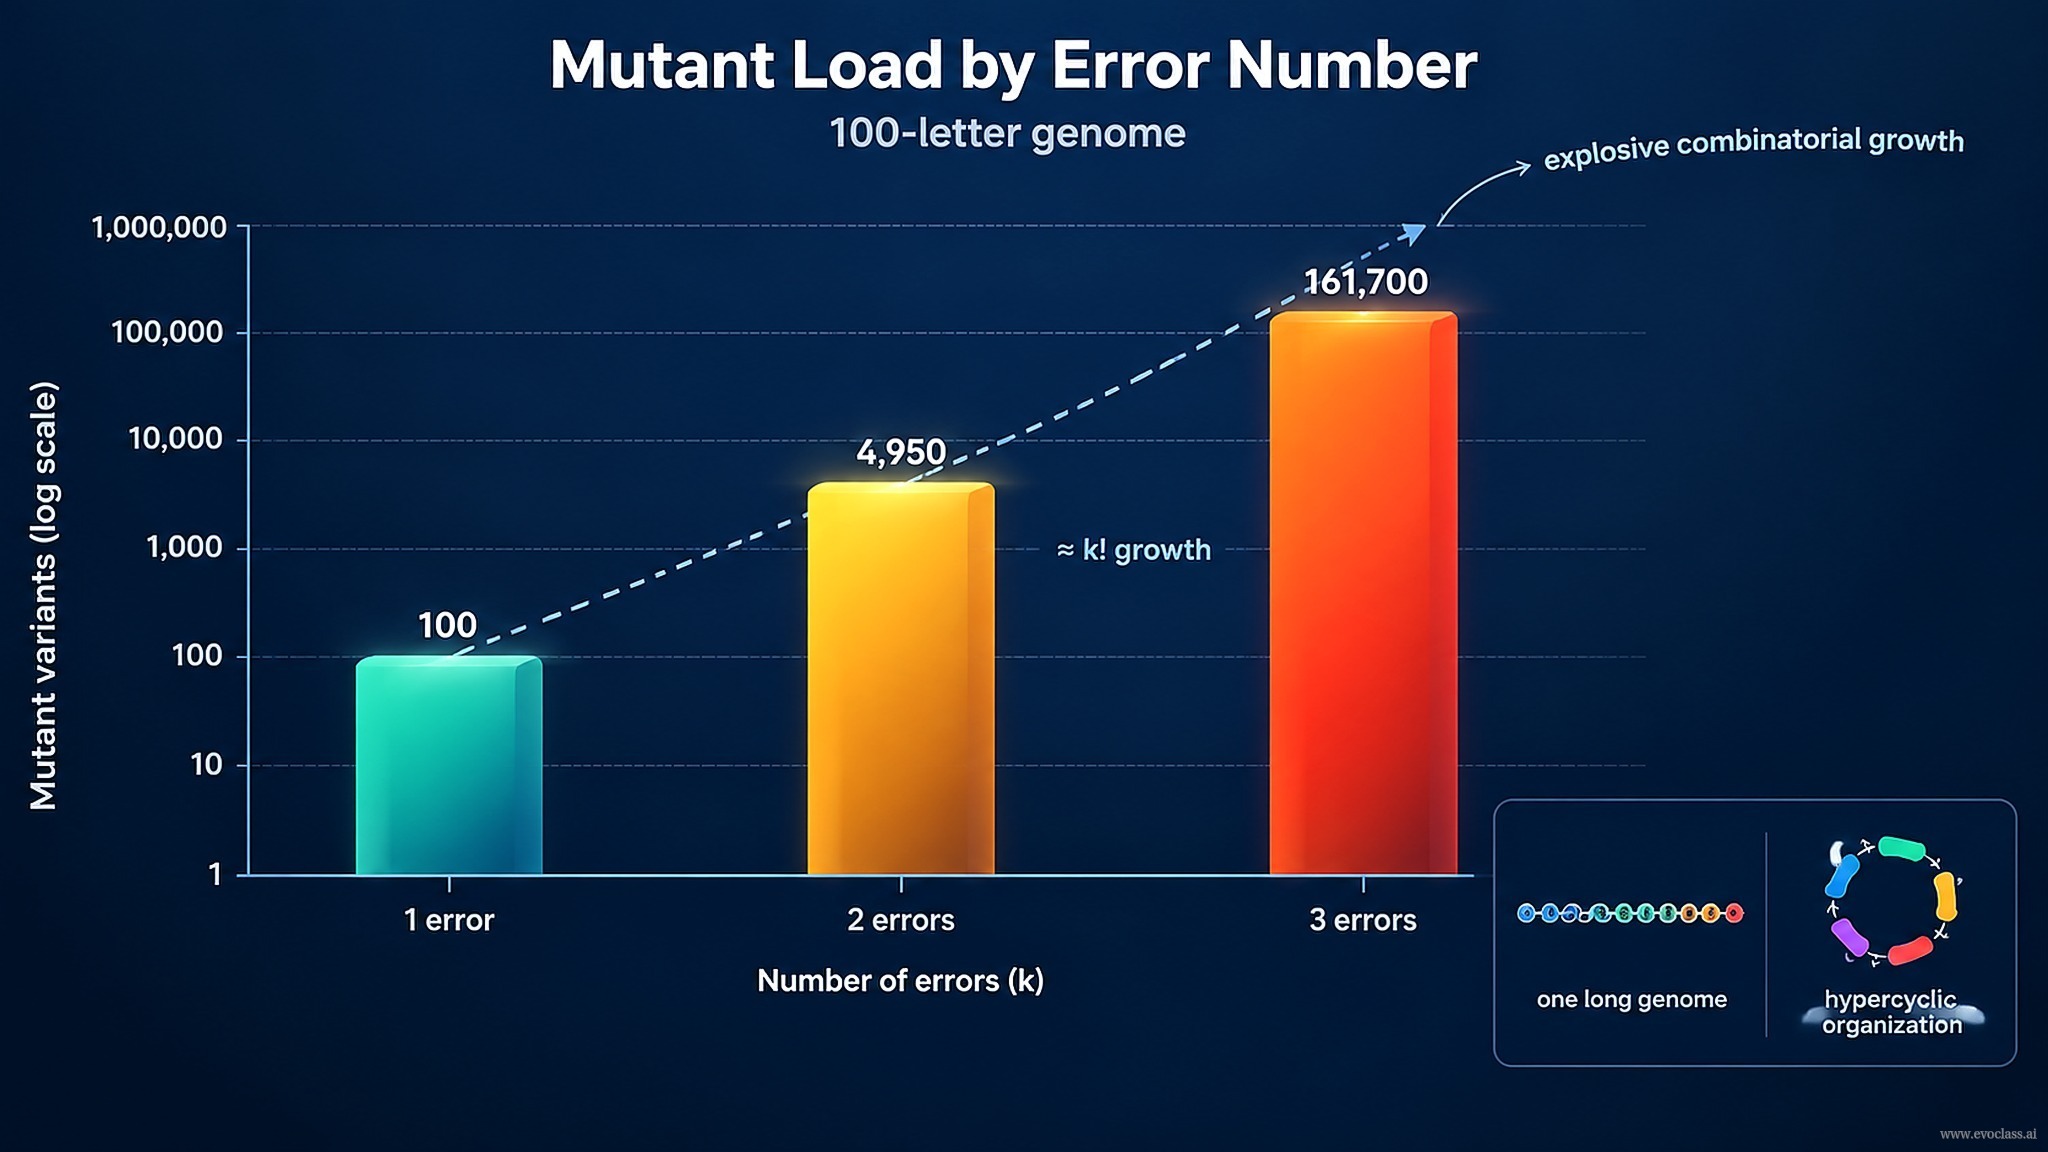
Một bộ gen có độ dài n phải đối mặt với không chỉ một tỷ lệ lỗi duy nhất. Với độ chính xác sao chép hữu hạn, mọi tổ hợp vị trí sao chép sai có thể có đều tạo ra một thể đột biến riêng biệt. Nếu đúng k vị trí bị sai, số thể đột biến k-lỗi có thể có là Nₖ = C(n, k). Với một bộ gen 100 chữ cái, các con số là 100 thể đột biến một lỗi, 4.950 thể đột biến hai lỗi, và 161.700 thể đột biến ba lỗi. Do đó, tải lượng đột biến không tăng theo tuyến tính; nó tăng theo tổ hợp với k.
Vì sao một Bộ gen Đơn lẻ Đang Phát triển lại Dễ bị Tổn thương
Một bộ gen phát triển đều đặn phải duy trì trình tự chủ đạo của mình đồng thời kìm hãm sự bùng nổ của các phương án thay thế gần kề. Khi n tăng, số thể đột biến k-lỗi có thể có với k nhỏ tăng nhanh chóng. Ngay cả khi tỷ lệ lỗi trên mỗi vị trí vẫn thấp, toàn bộ tập hợp các biến thể bị hỏng trở thành một hạn chế trọng tâm: chọn lọc phải ngăn không cho toàn bộ đám mây tổ hợp lấn át trình tự chức năng.
Tổ chức Siêu chu trình như một Chiến lược Thông tin
Tổ chức siêu chu trình đưa ra một giải pháp thay thế: phân tán gánh nặng thông tin cho các gen đơn đột biến ngắn hơn và tích hợp chúng thông qua ghép nối xúc tác theo chu trình. Các đơn vị ngắn hơn làm giảm tải lượng đột biến trên mỗi đơn vị vì mỗi gen có ít vị trí hơn và do đó có ít biến thể k-lỗi hơn. Ghép nối theo chu trình sau đó cho phép chọn lọc tác động lên siêu chu trình như một đơn vị cấp cao hơn thay vì lên một bộ gen dài. Do đó, lý lẽ cho tổ chức siêu chu trình không chỉ mang tính xúc tác mà còn mang tính thông tin: nó tổ chức đa dạng đột biến ở một cấp độ cao hơn.
Với n gen và Nₖ thể đột biến k-lỗi có sẵn, số cách phân bố các thể đột biến giữa các gen xấp xỉ (chọn n từ Nₖ + n − 1) ≈ Nₖⁿ / n! với n ≪ Nₖ. Điều này cho thấy một quần thể các đơn vị ngắn hơn có thể quản lý sự đa dạng mà một bộ gen đơn lẻ phát triển đều đặn sẽ bị quá tải như thế nào.
Tải lượng Đột biến theo Số lỗiBiểu đồ vẽ số lượng đột biến tổ hợp cho một bộ gen 100 chữ cái trên thang logarit: 100 thể đột biến một lỗi, 4.950 thể đột biến hai lỗi, và 161.700 thể đột biến ba lỗi. Sự gia tăng nhanh chóng cho thấy vì sao một bộ gen phát triển đều đặn phải đối mặt với đám mây biến thể bị hỏng ngày càng mở rộng, trong khi tổ chức siêu chu trình phân tán các gen ngắn hơn và tích hợp chúng thông qua ghép nối xúc tác theo chu trình.