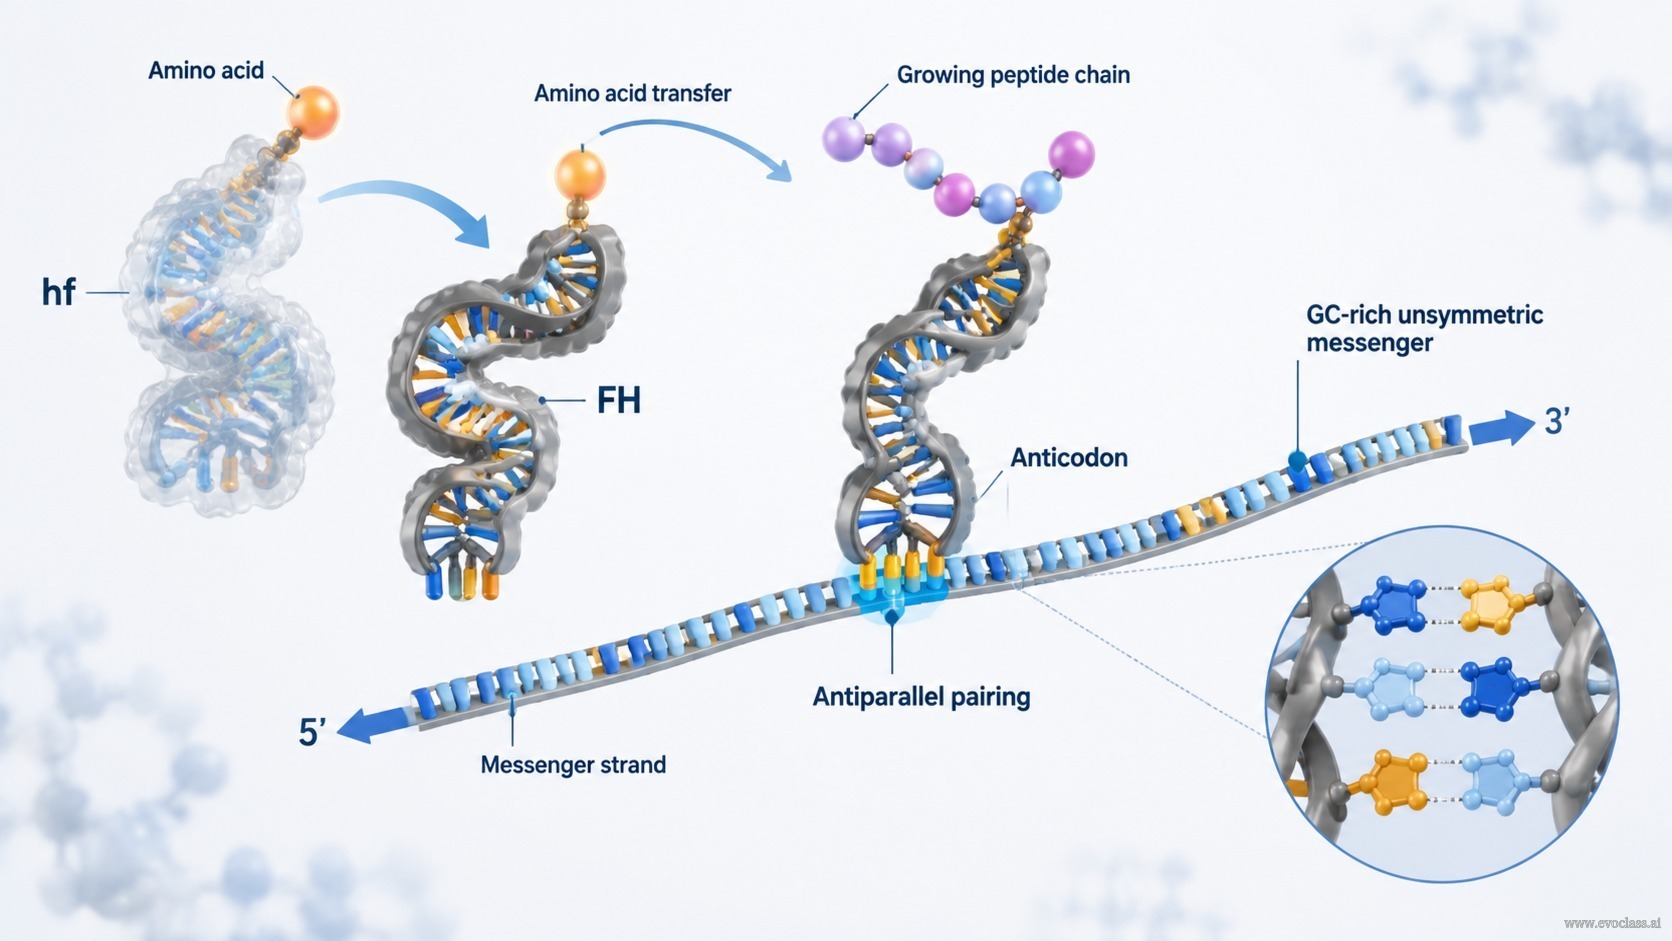
Dịch mã trong giai đoạn sơ khai của sự sống không nhất thiết phải bắt đầu bằng một ribosome hoàn chỉnh. Mô hình đề xuất rằng các adapter đơn giản giống tRNA có thể đọc một phân tử thông tin bằng cách bắt cặp bổ sung, đối song song, miễn là có sự hỗ trợ xúc tác cho việc hình thành liên kết peptide. Cấu hình của adapter phụ thuộc vào "hàng hóa" mà nó mang: nó mang cấu hình hf khi mang một amino acid và cấu hình FH khi mang một chuỗi peptide. Việc chuyển amino acid vào chuỗi peptide đang phát triển sẽ lật adapter từ hf sang FH (xem Hình 49).
Vì sự sắp thẳng hàng giữa adapter và phân tử thông tin là đối song song, một thông điệp có thể được đọc mà không cần bộ máy dịch mã phức tạp. Việc lựa chọn các mẫu khởi đầu giàu GC được quyết định bởi bốn lập luận, bao gồm độ ổn định của tương tác adapter–messenger và độ trung thực của quá trình sao chép, cả hai đều ủng hộ các tổ hợp GC để bắt đầu, và việc đọc không dấu phẩy trong dịch mã đòi hỏi một mẫu GC không đối xứng. Do đó, các mẫu messenger không dấu phẩy phát sinh từ việc tạo mẫu GC không đối xứng cho phép đọc mà không cần dấu phân cách hay bộ máy dịch mã phức tạp.
Các điểm cơ chế chính
- Hỗ trợ xúc tác vẫn cần thiết cho các chức năng dịch mã, nhưng dịch mã sơ khai có thể sử dụng các adapter đơn giản thay vì một ribosome đầy đủ.
- Cấu hình phụ thuộc hàng hóa: cấu hình của tRNA phụ thuộc vào việc nó mang một amino acid hay một chuỗi peptide. Việc chuyển sẽ lật hf sang FH.
- Bắt cặp đối song song: sự sắp thẳng hàng bổ sung giữa adapter và messenger là đối song song, cho phép đọc mà không cần bộ máy phức tạp.
- Mẫu giàu GC, không đối xứng: độ ổn định và độ trung thực sao chép ủng hộ GC; việc đọc không dấu phẩy đòi hỏi GC không đối xứng để tránh sự mơ hồ do khung chồng lấn.
Đọc Adapter–MessengerSơ đồ này thể hiện các adapter giống tRNA ở cấu hình hf và FH, sự bắt cặp bổ sung đối song song với một messenger giàu GC không đối xứng, và việc chuyển amino acid làm lật hf sang FH, cho phép đọc không dấu phẩy mà không cần một ribosome phức tạp.