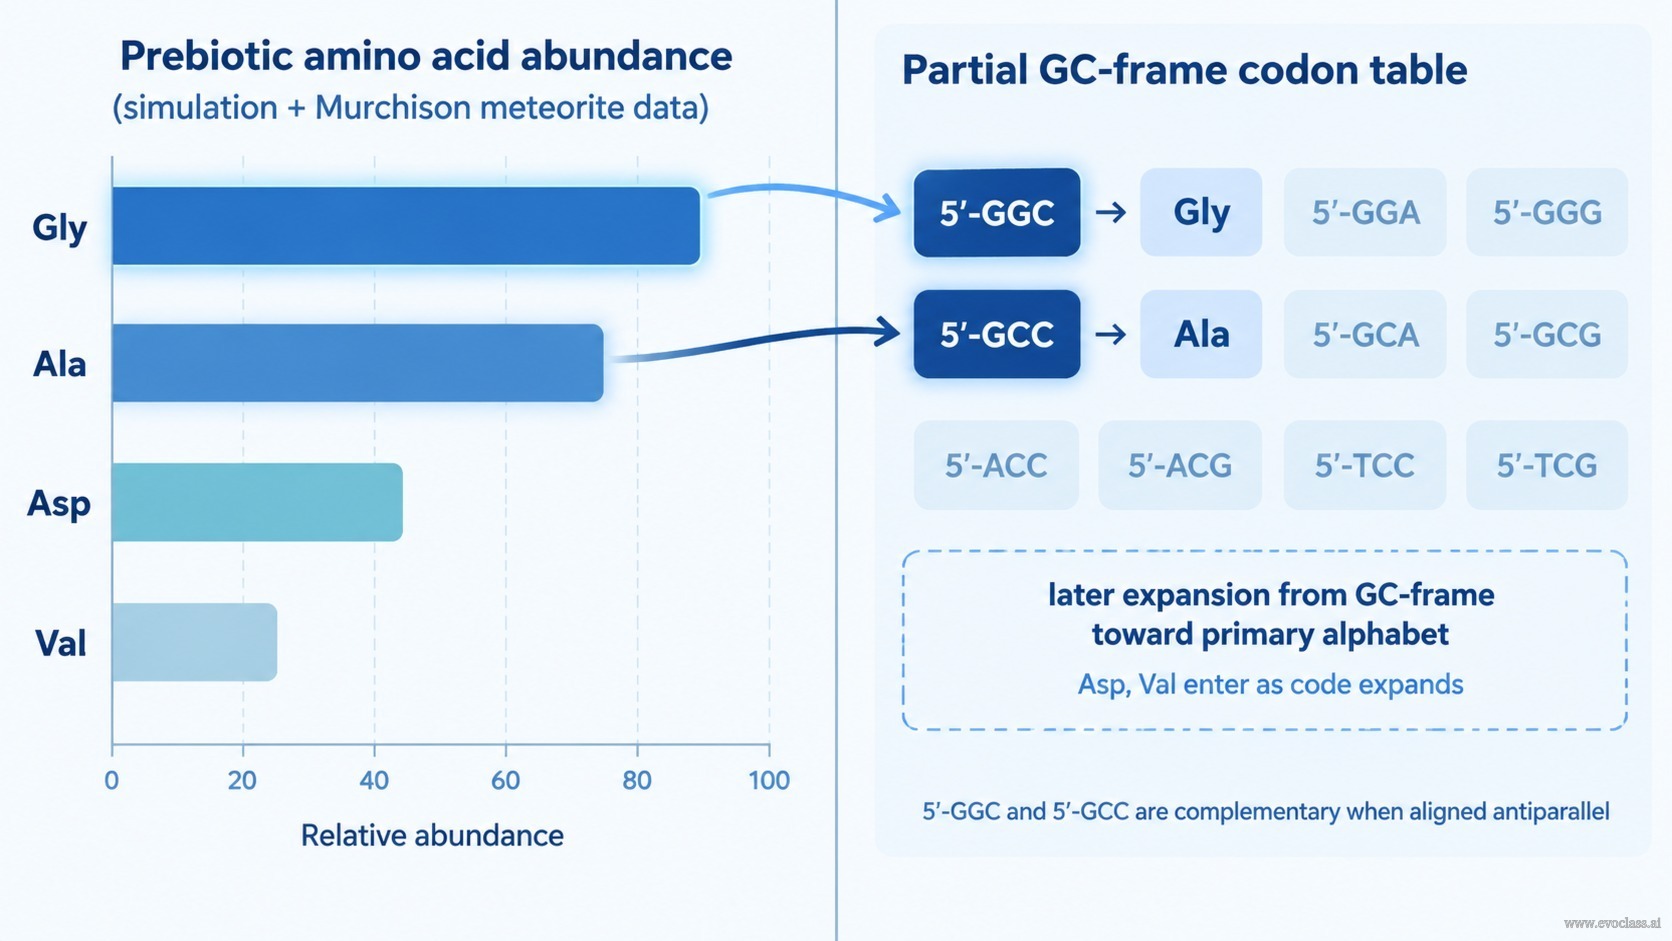
在前生命汤中,氨基酸的丰度并不均匀。米勒型合成实验与默奇森陨石分析得出了高度一致的排序: 甘氨酸 > 丙氨酸 > 天冬氨酸 > 缬氨酸。这一顺序不仅仅是描述性的,它还为最早的遗传密码提供了条件性的选择逻辑。如果第一个编码时期使用富含 GC 的模板,那么最丰富的氨基酸应当被优先招募。丰度最高的两种氨基酸——甘氨酸和丙氨酸——被分配到前两个 GC 阅读框密码子: 5′-GGC → Gly 以及 5′-GCC → Ala。这些分配将丰度列表的顶端置于非对称 GC 模式的开端,与富含 GC 的复制体制相一致。
为何优先选择富含 GC?
有四个论据支持从 GC 组合开始:(i) 衔接子–信使相互作用的稳定性,(ii) 复制的高保真度,二者都有利于 GC;(iii) 翻译中的无逗号读取,这需要非对称的 GC 模式;(iv) 与最丰富的益生元氨基酸相对应。前两个密码子 5′-GGC 和 5′-GCC 在反向平行对齐时互补,进一步强化了它们的核心地位。
天冬氨酸(Asp)和缬氨酸(Val)在丰度顺序中紧随其后。它们是在密码从最小 GC 阅读框向初级字母表扩展时才变得重要,而不是严格 GC 阅读框中的初始分配。
条件性推断: 这一重构假设丰度与早期功能可用性相关,并且富含 GC 的模板主导了第一个编码时期。其他情形——随机密码子分配或密码子与氨基酸之间的直接化学亲和力——在逻辑上仍然可能,需要独立的实验或系统发生学检验。
丰度到密码子的映射双面板示意图:左侧的排序条形图显示来自模拟和默奇森数据的益生元氨基酸丰度(Gly > Ala > Asp > Val);右侧的部分密码子表突出显示了首批 GC 阅读框密码子 5′-GGC(Gly)和 5′-GCC(Ala),并将 Asp 和 Val 标注为后期扩展的条目。
丰度到密码子的映射
双面板示意图:左侧的排序条形图显示来自模拟和默奇森数据的益生元氨基酸丰度(Gly > Ala > Asp > Val);右侧的部分密码子表突出显示了首批 GC 阅读框密码子 5′-GGC(Gly)和 5′-GCC(Ala),并将 Asp 和 Val 标注为后期扩展的条目。