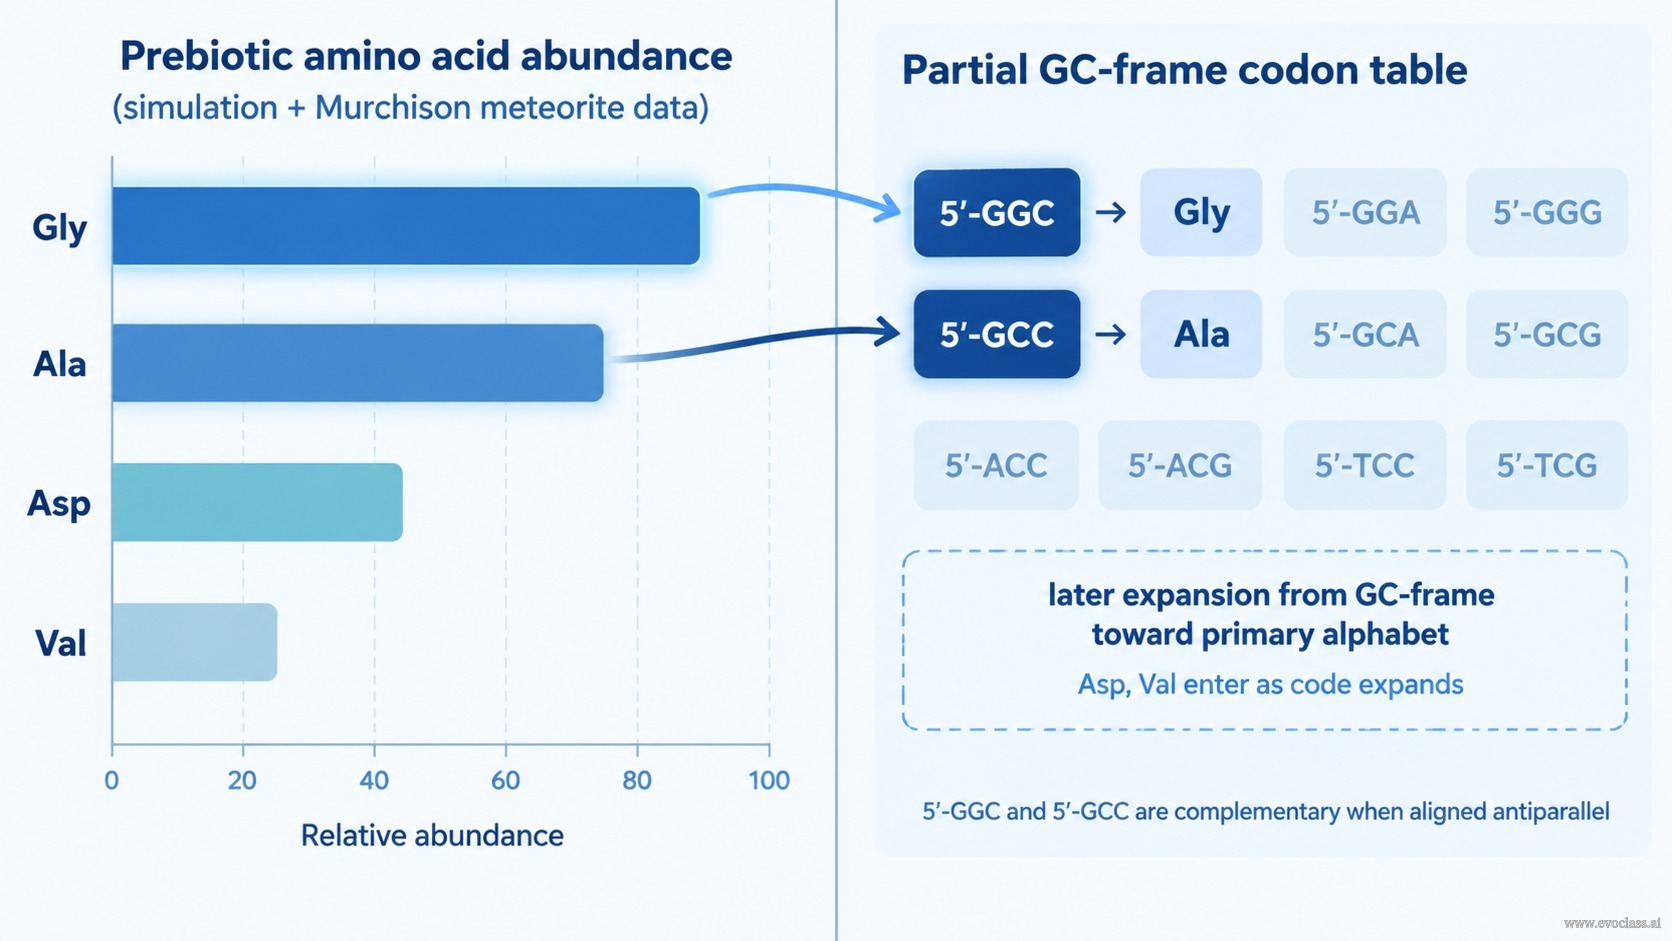
在前生命化學湯中,各種胺基酸的豐度並不均勻。米勒型合成實驗與默奇森隕石分析結果一致,收斂出以下排序: 甘胺酸 > 丙胺酸 > 天門冬胺酸 > 纈胺酸。這個排序不僅是描述性的,更為最早的遺傳密碼提供了一套條件式選擇邏輯。若第一個編碼時期使用富含 GC 的模板,那麼豐度最高的胺基酸理應最先被納入。豐度最高的兩種胺基酸——甘胺酸與丙胺酸——分別被指派給前兩個 GC 框架密碼子: 5′-GGC → Gly 以及 5′-GCC → Ala。這些指派將豐度排序的前兩名置於不對稱 GC 模式的開端,與富含 GC 的複製體制相符。
為何先從富含 GC 開始?
有四項論據支持以 GC 組合為起點:(i) 適配體與信使之間的交互作用穩定性;(ii) 複製的保真度,兩者皆偏好 GC;(iii) 轉譯時的無逗號讀取,這需要不對稱的 GC 模式;以及 (iv) 與前生命時期豐度最高之胺基酸的對應關係。前兩個密碼子 5′-GGC 與 5′-GCC 在反平行對齊時互補,進一步強化了它們的核心地位。
Asp 與 Val 在豐度排序中位居其後。牠們是在密碼從最小 GC 框架擴展至主要字母表時才變得相關,而非嚴格 GC 框架下的初始指派。
條件式推論: 此重建假設豐度與早期功能可用性相關,且富含 GC 的模板主導了第一個編碼時期。其他可能情境——隨機指派密碼子,或密碼子與胺基酸之間直接的化學親和力——在邏輯上仍然成立,且需要獨立的實驗或親緣分析檢驗。
豐度至密碼子的對應雙面板圖示:左側以排序長條圖呈現模擬與默奇森資料所得的前生命胺基酸豐度(Gly > Ala > Asp > Val);右側為部分密碼子表,標示出首批 GC 框架密碼子 5′-GGC(Gly)與 5′-GCC(Ala),並將 Asp 與 Val 標為後期擴展的項目。
豐度至密碼子的對應
雙面板圖示:左側以排序長條圖呈現模擬與默奇森資料所得的前生命胺基酸豐度(Gly > Ala > Asp > Val);右側為部分密碼子表,標示出首批 GC 框架密碼子 5′-GGC(Gly)與 5′-GCC(Ala),並將 Asp 與 Val 標為後期擴展的項目。